
虹安 的 X 帖子
@yaohongan2025
【GEO 入门:5 个今天就能做的动作,做完 AI 才“看得见”你】
先说个这两天我身边最明显的变化。
我上周写完一篇找词的教程,后台好几个人问我同一个问题:词我找到了,站我也做出来了,可怎么让 AI 在回答里提到我?以前做站,大家盯的是谷歌排名;现在越来越多人发现,真正带来注册、带来订单的,是 ChatGPT、是豆包,是用户直接问 AI “买哪个好”的时候,AI 有没有报出你的名字。
这事有个名字,叫 GEO,生成式引擎优化。
正好昨天出了件标志性的事。DeepSeek 在 10 月 17 号开放了自研的搜索 API,我去翻了官方文档,发现它给每个网页都打了两个分:一个叫 rerank_score,从相关性、权威性、时效性三个维度打,0 到 3 分;另一个叫 authority,权威度,0 到 4 分。文档里还写明了门槛:rerank_score 到 1.5 分算优质结果,authority 到 3 分算极权威(来源:DeepSeek 官方文档 api-docs.deepseek.com/zh-cn/guides/search/)。另外据虎嗅转述官方公告,它会专门过滤掉 SEO 作弊、GEO 操纵和低质的 AIGC 内容(据报道,虎嗅)。
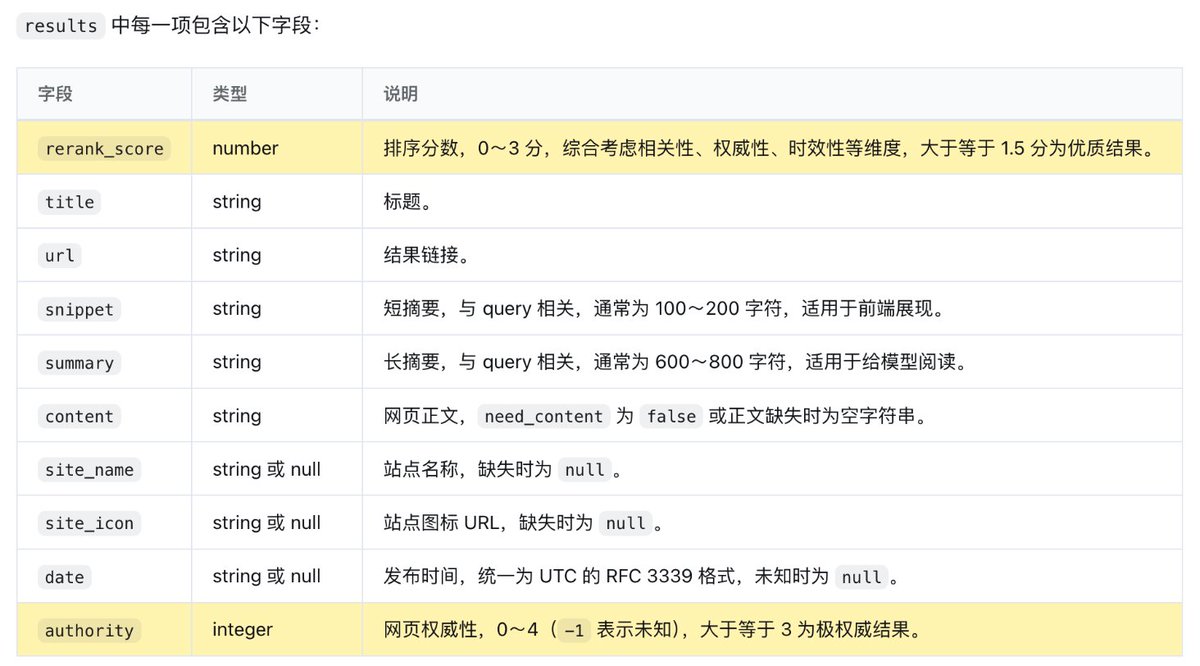
你品一下这个信号。AI 搜索不再是抓到啥给啥了,它开始给内容打分、挑内容了。
那怎么办?我翻了一圈,网上教 GEO 的,十个里有八个上来就让你搞 llms.txt、堆一堆 schema 标记。说实话,我认真扒了官方文档和几份正经研究之后,结论挺反常识的:这俩东西,对绝大多数人基本没用。真正今天就能做、而且有据可查管用的,是另外五件事。
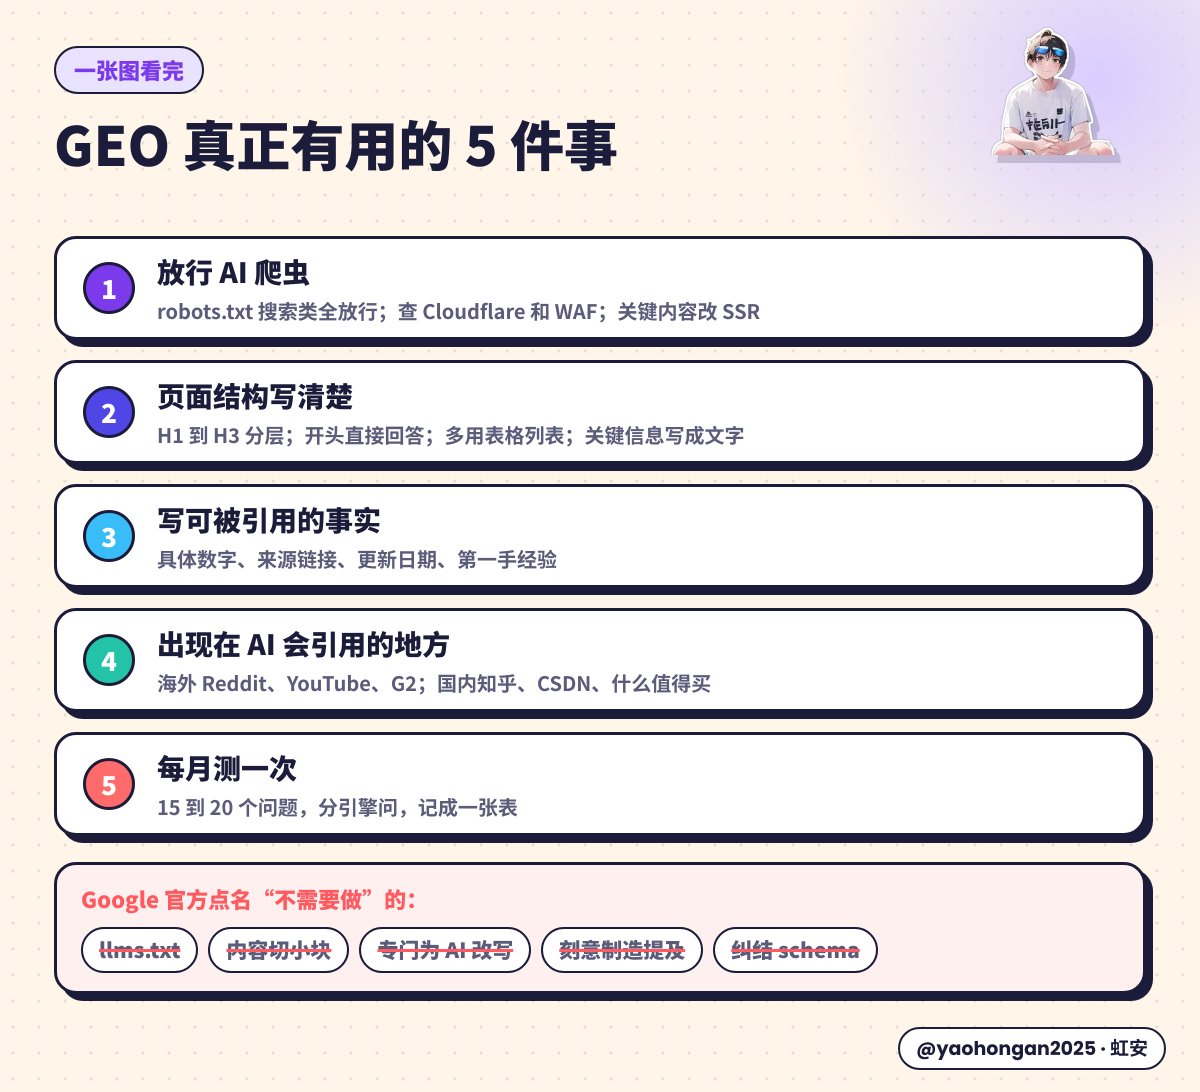
这篇我一件一件给你讲清楚,每条结论我都标了出处。自述的数据我标“据作者说”,没亲自核实的标“据报道”,我不编数字。文章有点长,建议先收藏,照着做。
一、先搞清楚 GEO 和 SEO 到底什么关系
很多人把 GEO 当成一个全新的、要推翻 SEO 重来的东西。不是的。
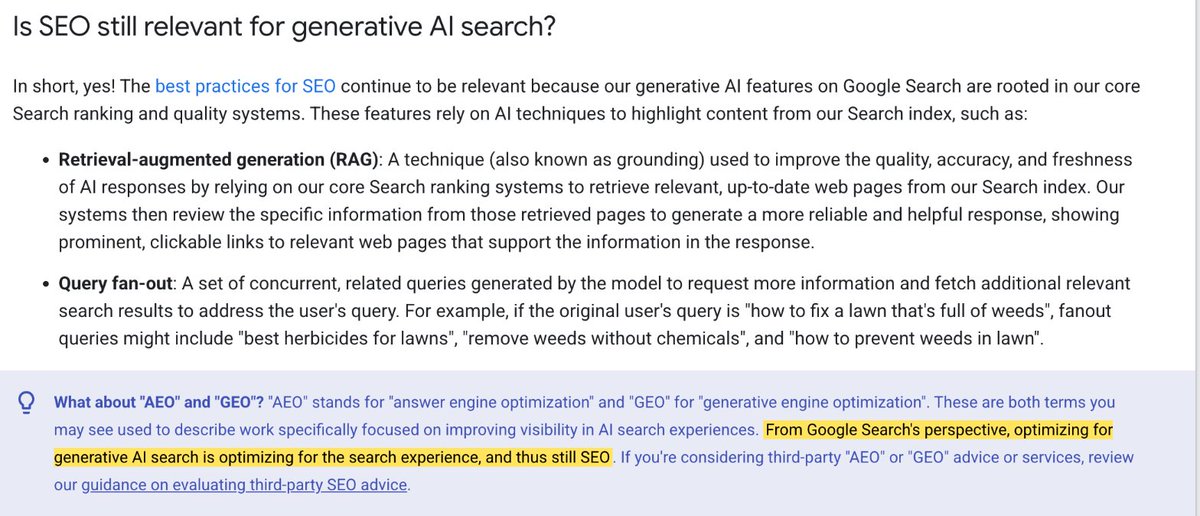
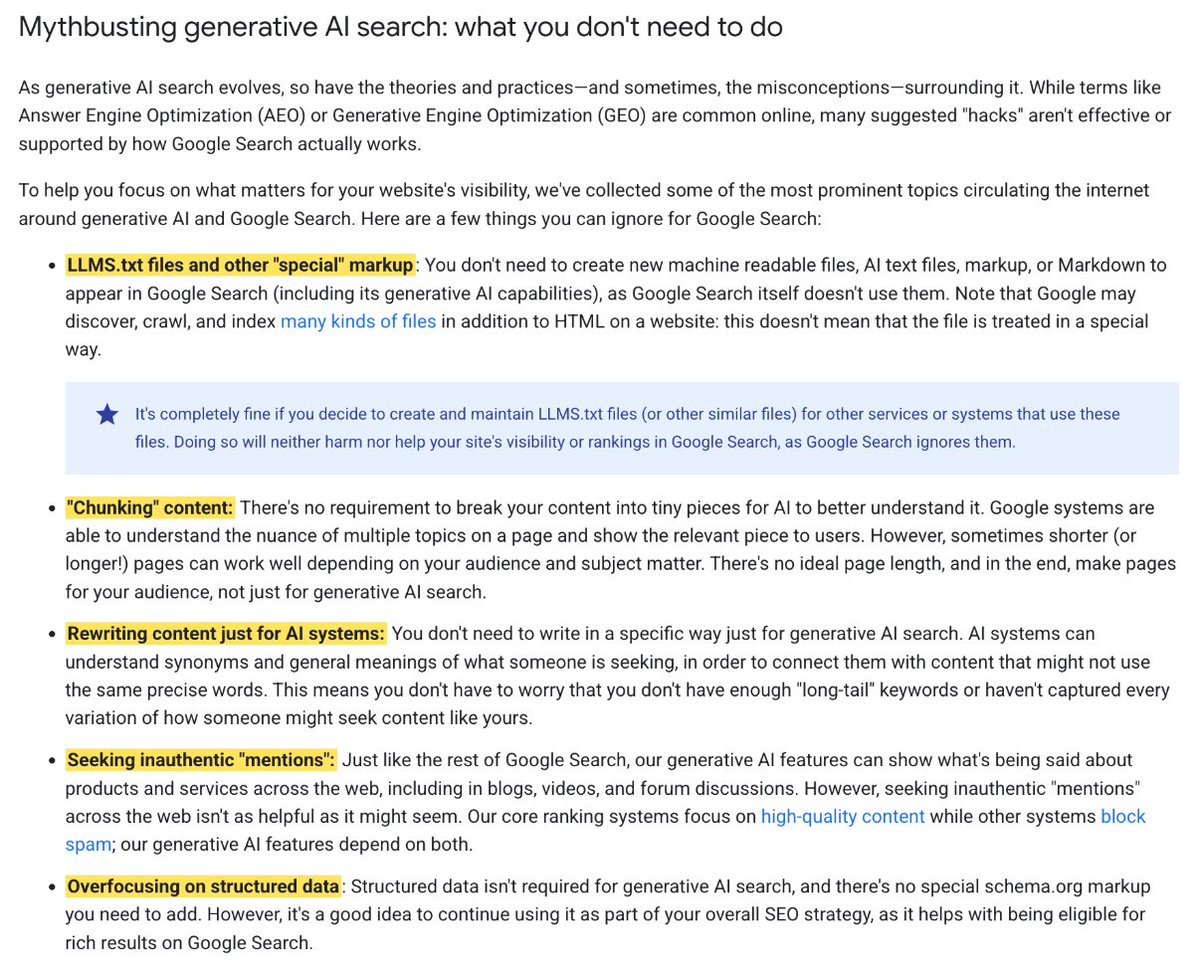
谷歌自己在 2026 年 5 月出的官方指南里,原话就是:为生成式 AI 搜索做优化,“仍然是 SEO”(来源:Google 官方 AI 优化指南)。同一份指南还专门列了一串“你不需要做的事”,我看完乐了,里面点名的正是:llms.txt、把内容切成小块、专门为 AI 把内容改写一遍、刻意制造别人对你的提及、纠结 schema。
换句话说,一堆人正在花大力气做的,恰恰是官方说不用做的。
那什么有用?普林斯顿等机构有一篇 GEO 的论文(KDD 2024,arXiv:2311.09735),做了实测,结论很具体:往内容里加统计数据、加引语、标清来源,这三样最有效,能把 AI 引用的可见度提升 30 到 40 个百分点。这里要说清楚,30 到 40 是上限,不是平均,别指望每篇都这样。
更有意思的是另一组数据。原本排在第 5 位的网站,做了这些之后提升了约 100%;而原本排第 1 的,反而掉了 20 到 30%。这说明啥?说明 GEO 这件事,小站、腰部站最受益。你排名靠后、没什么人认识,正是你该做的理由,不是不做的借口。还有一条,关键词堆砌,基本无效,别费那劲了。
所以一句话:GEO 不是 SEO 的对立面,它是 SEO 的基本功,再加上一条,让 AI 认得出你、愿意引用你。下面这五个动作,就是围着这条展开的。
二、动作一:robots.txt,先把 AI 爬虫放进来
这是地基里的地基。AI 要引用你,前提是它的爬虫能进得来、读得到。很多人站做得挺好,结果把人家挡在门外了还不知道。
先分清楚,AI 爬虫不是一种,是三种,作用完全不同:
第一种,搜索类。这类直接决定你能不能被 AI 引用,必须放行:OAI-SearchBot、PerplexityBot、Claude-SearchBot,还有 Googlebot、Bingbot。
第二种,用户触发类。就是用户在 AI 里点了你的链接、AI 实时去抓那一下:ChatGPT-User、Perplexity-User、Claude-User。这类也建议放行。
第三种,训练类。是拿你的内容去训练模型的:GPTBot、ClaudeBot、Google-Extended。这类你禁掉,不影响你被搜索引用,介意版权的可以禁。
(来源:OpenAI、Perplexity、Anthropic、Google 各自的官方爬虫文档)
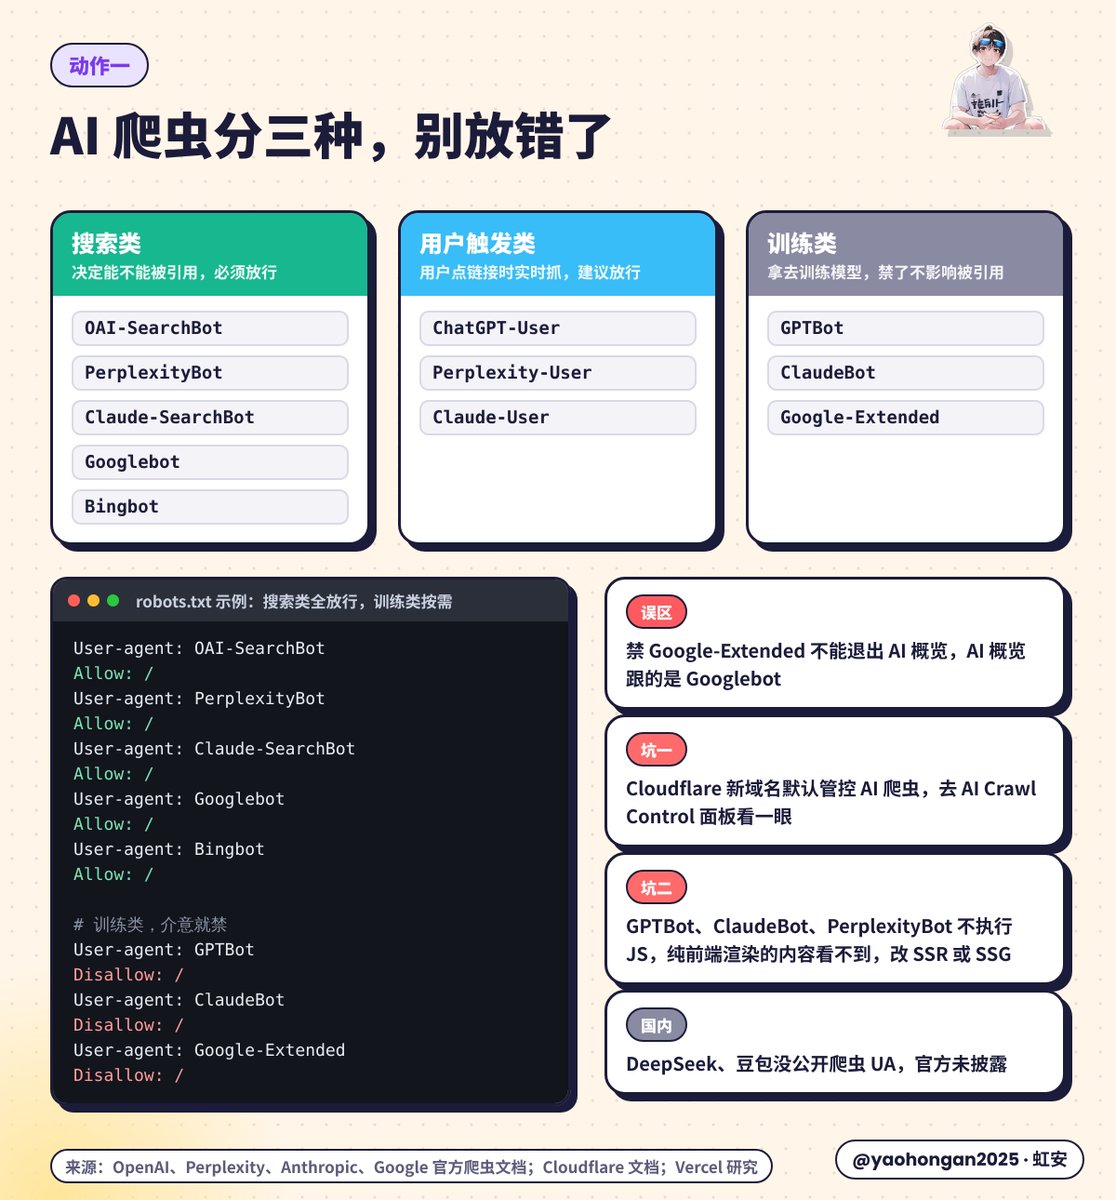
这里有个特别常见的误区,我见好多人栽过:以为禁了 Google-Extended 就能让自己从谷歌的 AI 概览里消失。错的。AI 概览跟的是 Googlebot,不是 Google-Extended。你把 Google-Extended 禁了,该出现还出现,只是白禁。
给你一段能直接抄的示例,思路就是“搜索类全放行,训练类按需决定”:
User-agent: OAI-SearchBot
Allow: /
User-agent: PerplexityBot
Allow: /
User-agent: Claude-SearchBot
Allow: /
User-agent: Googlebot
Allow: /
User-agent: Bingbot
Allow: /
# 训练类,介意就禁,不影响被引用
User-agent: GPTBot
Disallow: /
User-agent: ClaudeBot
Disallow: /
User-agent: Google-Extended
Disallow: /
放行了就完事了吗?还有两个坑,踩中了前面全白做。
坑一,Cloudflare。如果你的域名挂在 Cloudflare,新域名默认是会帮你管控 AI 爬虫的,它 2025 年 7 月和 2026 年 9 月改过两次默认策略。你 robots.txt 写得再开放,Cloudflare 在外面那层给你拦了,爬虫一样进不来。去它的 AI Crawl Control 面板里亲自看一眼(来源:Cloudflare 官方文档)。
坑二,渲染方式。GPTBot、ClaudeBot、PerplexityBot 这些,不执行 JavaScript。也就是说,你那些纯前端渲染、要靠 JS 跑出来的内容,它们根本看不见,抓到的是一个空壳(据 Vercel 的研究)。解决办法是改成 SSR 或者 SSG,让关键内容在 HTML 里就是现成的。这条对用 React、Vue 纯客户端渲染做站的人尤其重要。
对了,国内的 DeepSeek、豆包,目前没公开自己的爬虫 UA,所以这块我只能写“官方未披露”,没法给你确切的名字。
最后说回 llms.txt。为什么我说它基本没用,不是我拍脑袋。Ahrefs 研究了 13.7 万个域名,97% 的 llms.txt 文件零请求,根本没 AI 来读(Ahrefs 研究);SE Ranking 研究了 30 万个域名,发现它和被不被引用没关系;谷歌更是直接说了不使用。结论就一句:文档类站点想加可以加,图个整齐,但你要是指望它给你带来 AI 引用,别想了。
三、动作二:页面结构,做给人看,也做给 AI 看
这一步很多人想复杂了,花钱去堆 schema 结构化数据,以为是什么秘籍。
Ahrefs 做过一个很严谨的双重差分研究,给 1885 个页面加上 schema,结果 AI 引用基本没提升(Ahrefs 研究)。原因也讲清楚了:AI 实时抓取的时候,只读页面上看得见的那部分 HTML。你埋在代码里用户看不见的标记,它很多时候压根不理。
那真正有用的是什么?是看得见的结构,说白了就是把文章写得清楚:
标题层级要清楚,H1、H2、H3 一层套一层,别乱。每一段开头,直接把这段要回答的问题答了,别绕。一段只讲一个问题,别一段塞五件事。能用表格、能用列表的地方,就用,AI 特别爱抓这种结构化的信息。还有,关键信息一定要落成文字,别只放在图片里,AI 读不出图里的字(参考 Vercel 的做法)。
schema 要不要做?做,但当成基本功做就行。Organization、Product、SoftwareApplication、Article 这几个该标标上,它不会害你,但别把它当成能让你一飞冲天的秘籍。
你发现没有,这一节的要求,和“把文章写得让人读着舒服”几乎是一回事。这不是巧合。
四、动作三:写出真能被引用的事实
AI 愿意引用什么样的内容?前面论文已经说了,带数据、带引语、带来源的。落到你写东西的时候,就四件事:
写具体的数字,别写“很多”写“3.79 万次”。给数据配上来源链接,让它可查。标上更新日期,让它知道这是新的。最值钱的是第一手经验,你自己做出来、测出来的东西,别人没有。
谷歌在指南里专门点了一个词,叫“非同质化内容”,意思就是别人没有的东西。Vercel 给了个特别好用的自检标准,我现在写东西都拿它卡自己:你写完这段,问一句,竞品明天能不能轻松复制?如果能,就再往下挖一层,挖到别人复制不了为止。
还有个容易忘的:内容要养。建议每 30 天、90 天、180 天回头复查一遍,过时的更新掉,同时把 sitemap 里的 lastmod 日期更新,让 AI 知道你这页是活的。
五、动作四:出现在 AI 真会去引用的地方
这一步,是我觉得对新站最关键、也最容易被忽略的一条。
你光把自己站内写好还不够,因为 AI 引用的,很多根本不是你的官网,是别人讨论你的地方。
Profound 分析了 6.8 亿条 AI 引用(Profound 研究),发现 ChatGPT 最爱引维基百科,Perplexity 最爱引 Reddit。这里有个数据口径特别容易被人拿去唬人,我得给你说清楚:网上流传的“Reddit 占 46.7%”,指的是在前 10 大来源内部的份额,如果算占全部引用,Reddit 其实只有 6.6%。差了快七倍,看数据一定看清口径。
更关键的是,中文引擎的偏好和海外完全是两套。复旦有篇论文(arXiv:2610.11932)测出来:文心偏爱百家号,豆包偏爱头条,基本各家都偏向自己生态里的内容。有意思的是,“什么值得买”被测的 10 家引擎全都引用了,算是个通吃的存在。
所以结论很直接:你做海外,就去 Reddit、YouTube、G2、维基百科上有真实的存在;你做国内,就去知乎、CSDN、什么值得买、头条上有内容。
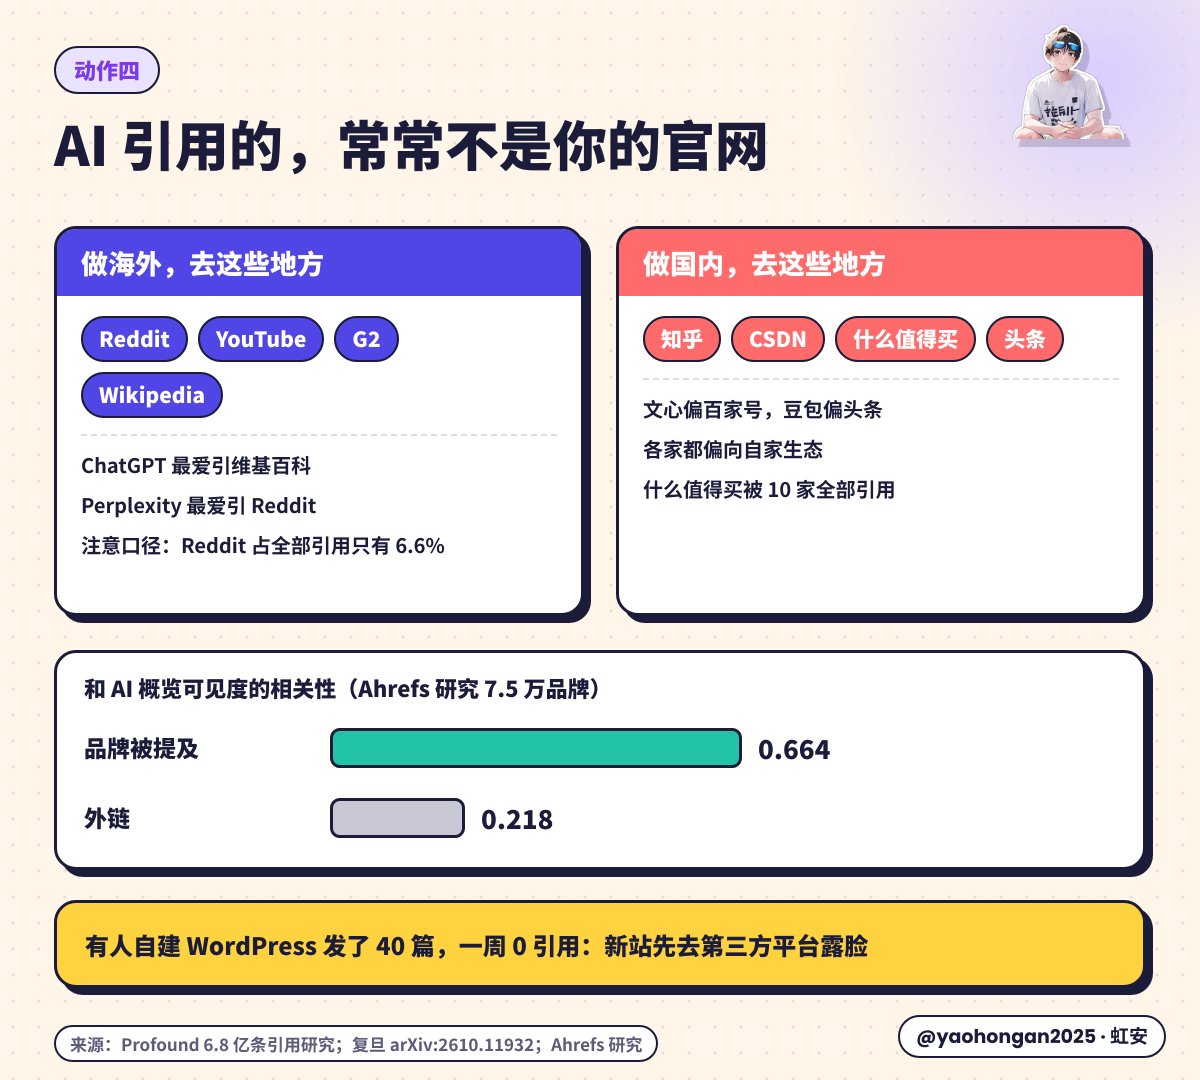
这里有个血淋淋的对比。同一篇研究里提到,有人自建 WordPress 吭哧吭哧发了 40 篇文章,一周下来,0 引用。为什么?因为新站在 AI 眼里没有信任度。新站想被引用,必须先在第三方平台上有真实的、被人讨论的存在。这不是走捷径,这是先让 AI 在别的地方认识你。
还有一组数据能印证这个方向。Ahrefs 研究了 7.5 万个品牌,发现品牌提及和 AI 概览可见度的相关性是 0.664,而外链的相关性只有 0.218(Ahrefs 研究)。翻译一下:别人提到你的名字,比你辛辛苦苦换外链,重要得多。
具体怎么做,可以参考 Tally 的打法:做“X vs Y”的对比页、做“X 替代品”的页面,这两类正是用户在 AI 里最爱问的;经营自己的 subreddit;创始人亲自下场去相关的帖子下回答问题。你在对比里出现得够多,AI 做推荐的时候自然绕不开你。
这里多说一句创始人亲自回答这件事,看着土,其实是性价比最高的动作之一。你想,一个真人创始人,在 Reddit 或者知乎某个相关问题下,认真回答了别人的疑问,留下了你产品的真实使用场景,这段内容对 AI 来说是双重加分:既是第三方平台上的真实提及,又带着别人问不出来的第一手信息。你花钱买十条软文,可能都不如创始人自己认真回几个问题管用。做这件事不要脸皮薄,你比谁都懂自己的产品。
六、动作五:每个月,测一次
前面四步都是做。这一步是测。不测,你根本不知道自己做得有没有用,全凭感觉,那不行。
测法不复杂,我给你一套能照着跑的:
先准备 15 到 20 个问题,分三类。品牌词,直接问你的名字,比如“XX 这个工具怎么样”;品类词,问你所在的品类,比如“有哪些好用的 XX 工具”;对比词或替代品词,比如“XX 和 YY 哪个好”“XX 的替代品有哪些”。
然后每个问题,在 ChatGPT(记得开搜索)、Perplexity、Gemini、谷歌 AI Mode 里都问一遍,做国内就再加上豆包、DeepSeek、Kimi、元宝。关键一点:用无痕窗口或者登出状态问,不然它会被你自己的历史带偏。每个问题跑 2 到 3 次,因为 AI 每次回答会有波动。
怕你没概念,我拿一个虚构的 AI 工具站举个例子,假设它叫 NoteFlow,做的是 AI 会议记录。你的清单可以这么列:
品牌词,比如“NoteFlow 好用吗”“NoteFlow 怎么收费”“NoteFlow 安全吗”。
品类词,比如“有哪些好用的 AI 会议记录工具”“免费的会议转文字工具推荐”“适合团队的会议纪要软件”。
对比词和替代品词,比如“NoteFlow 和 Otter 哪个好”“Otter 的平价替代品”“有没有支持中文的会议记录工具”。
你自己的站,把 NoteFlow 换成你的名字,把品类换成你的品类,二十来个问题很快就凑齐了。
记成一张表,记这几列:有没有提到你、排第几、说法对不对、引用了哪些网址、竞品是谁。表格很重要,因为你测第二个月的时候,要跟第一个月对着看,才知道自己做的那些动作到底有没有推动排名往上走。
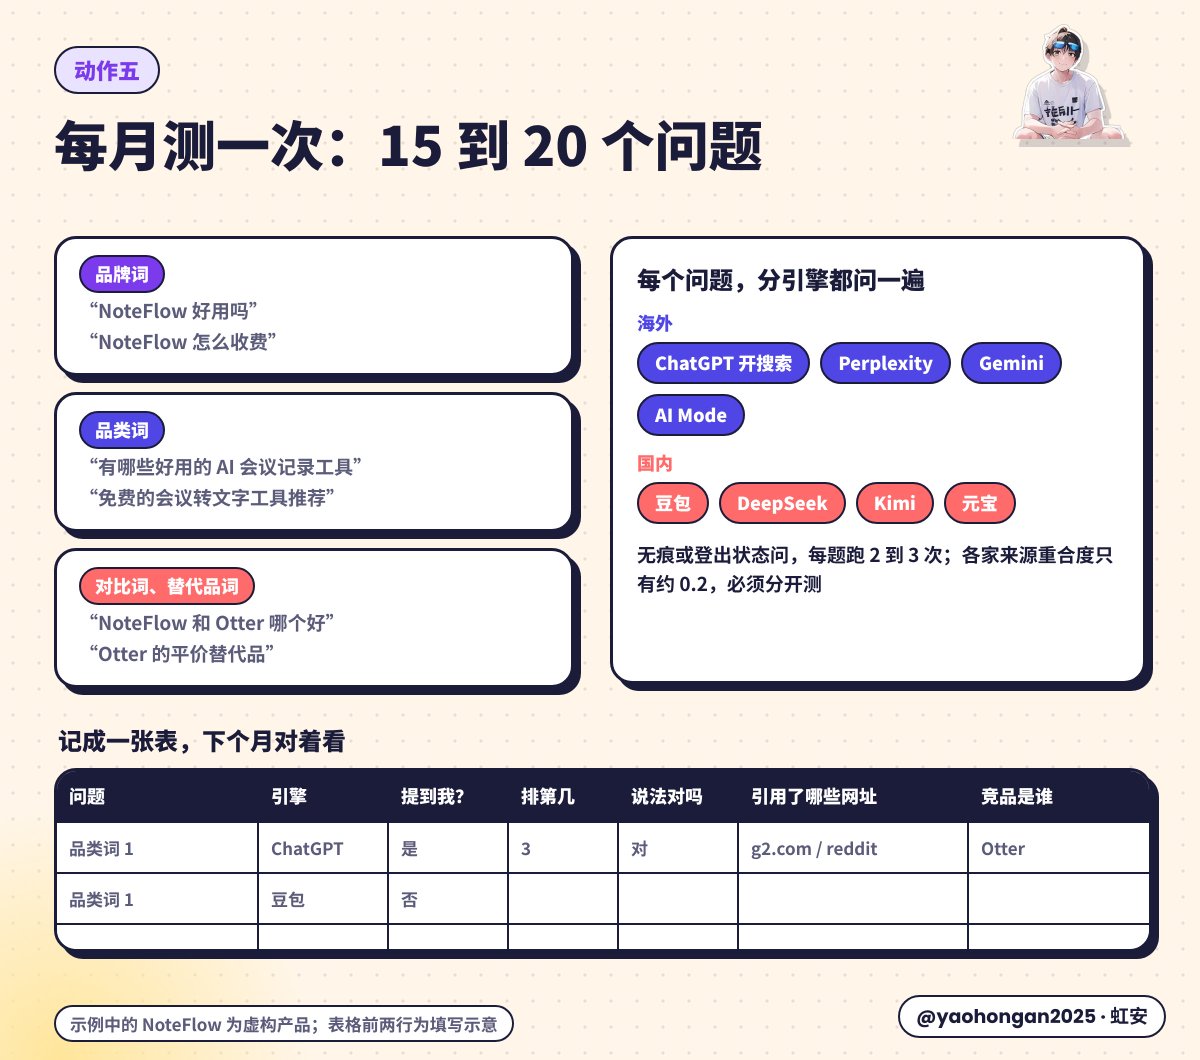
为什么要这么麻烦,一家一家测?因为各家引擎的来源重合度只有大约 0.2,意思是你在 ChatGPT 里表现好,不代表在 Perplexity 里也好,它们看的来源几乎是两拨。必须分开测。
官方其实也开始给数据了,别浪费:Bing 的站长工具出了 AI Performance 报告;谷歌 GSC 有生成式 AI 报告,不过目前只给展示次数;GA4 可以自己建一个“AI 渠道组”来统计,ChatGPT 过来的链接会自动带上 utm_source=chatgpt.com,很好认。免费工具可以用 HubSpot 的 AI Search Grader 先测个底。
还有个特别聪明的土办法,是跟 Tally 学的:在你的注册流程里,直接加一个问题,问用户“你是哪个 AI 推荐你来的”。用户亲口告诉你,比任何后台都准。
七、12 个真实案例,自己感受一下
讲了这么多方法,到底有没有用?我扒了一圈公开案例,排成一张表给你看。自述的数据我都标了“据作者说”,没核实的标“据报道”。你重点看最后一条,那是盆冷水。
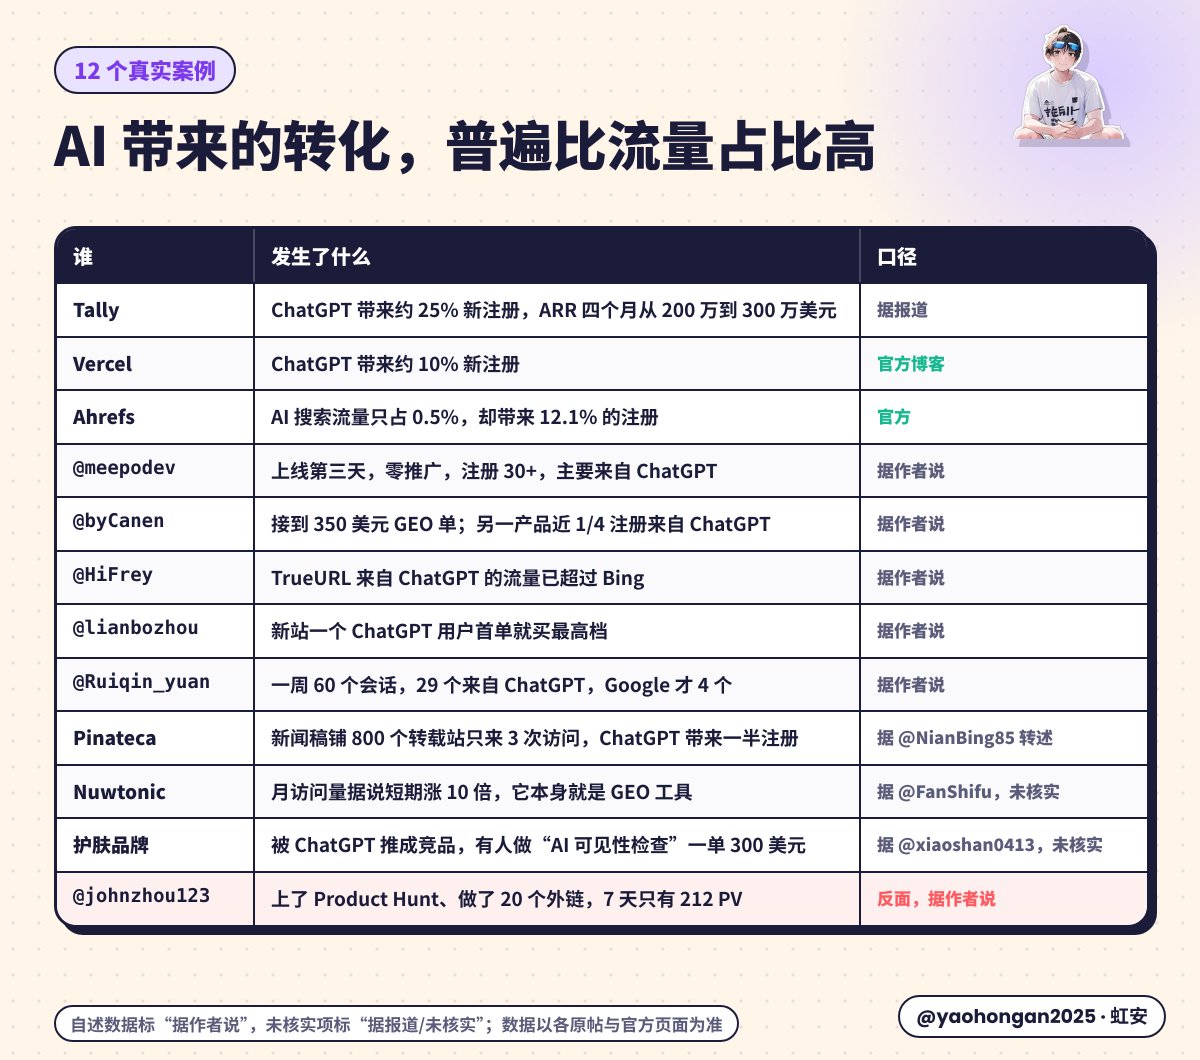
• Tally:ChatGPT 带来约 25% 新注册,ARR 四个月从 200 万到 300 万美元(据报道,foundationinc)
• Vercel:ChatGPT 带来约 10% 新注册(Vercel 官方博客)
• Ahrefs:AI 搜索流量只占 0.5%,却带来 12.1% 的注册(Ahrefs 官方)
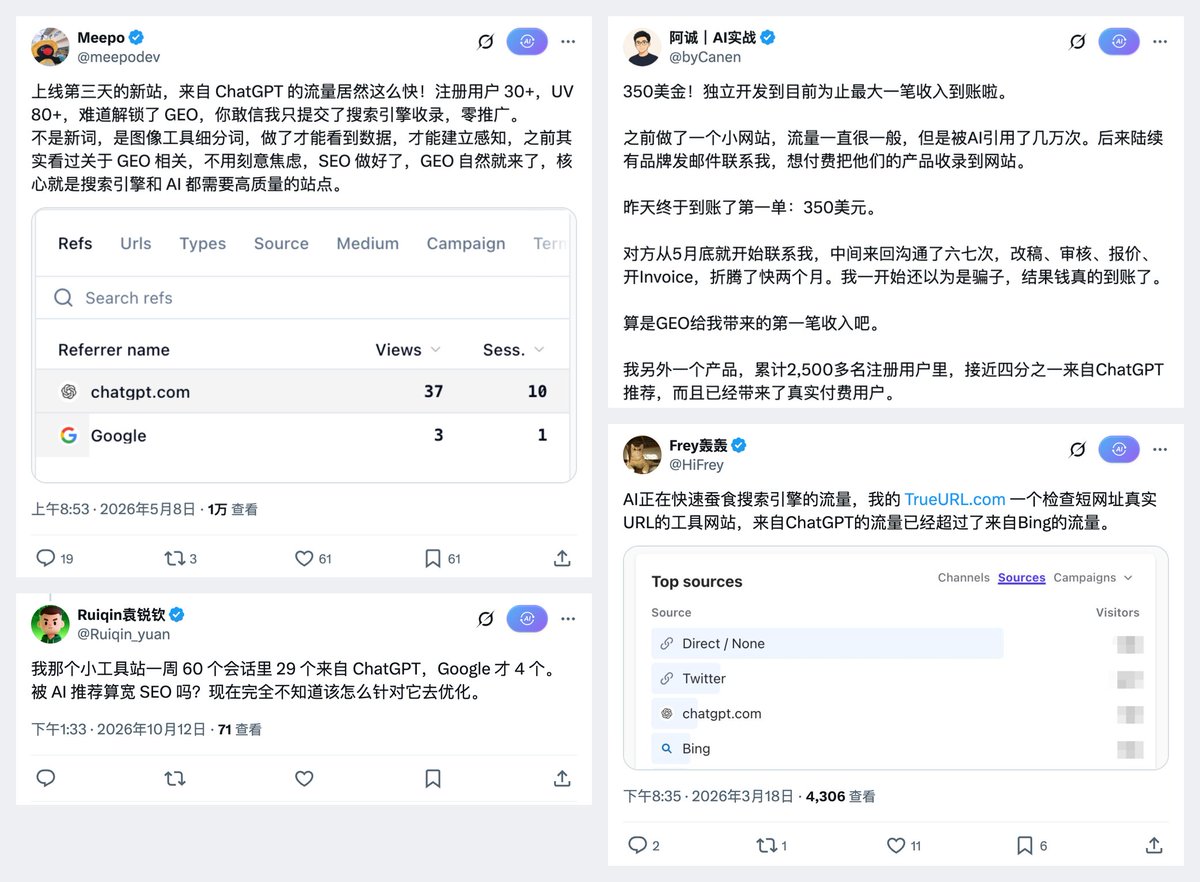
• @meepodev:上线第三天的新站,零推广只提交收录,注册 30+、UV 80+,主要来自 ChatGPT,做的是图像工具细分词(据作者说)
• @byCanen:一个站被 AI 引用几万次,接到第一笔 350 美元的 GEO 收录单;另一产品 2500+ 注册里近 1/4 来自 ChatGPT(据作者说)
• @HiFrey:短网址工具 TrueURL,来自 ChatGPT 的流量已超过 Bing(据作者说)
• @lianbozhou:新站没正式推广,一个 ChatGPT 用户首单就买了最高档,做的还是老词(据作者说)
• @Ruiqin_yuan:小工具站一周 60 个会话,29 个来自 ChatGPT,Google 才 4 个(据作者说)
• Pinateca:免费新闻稿发到约 800 个转载站,5 天只带来 3 次访问;同期 6 个注册里 3 个来自 ChatGPT(据 @NianBing85 转述)
• Nuwtonic:踩着 GEO 风口,月访问量据说短期涨了 10 倍(据 @FanShifu 拆解,10 倍未核实,且它本身是 GEO 工具)
• 护肤品牌案例:顾客问 ChatGPT 被领到竞品、还报了旧价,有人把“AI 可见性检查”做成收费服务,一单 300 美元(据 @xiaoshan0413 转述,Reddit 原帖未核实)
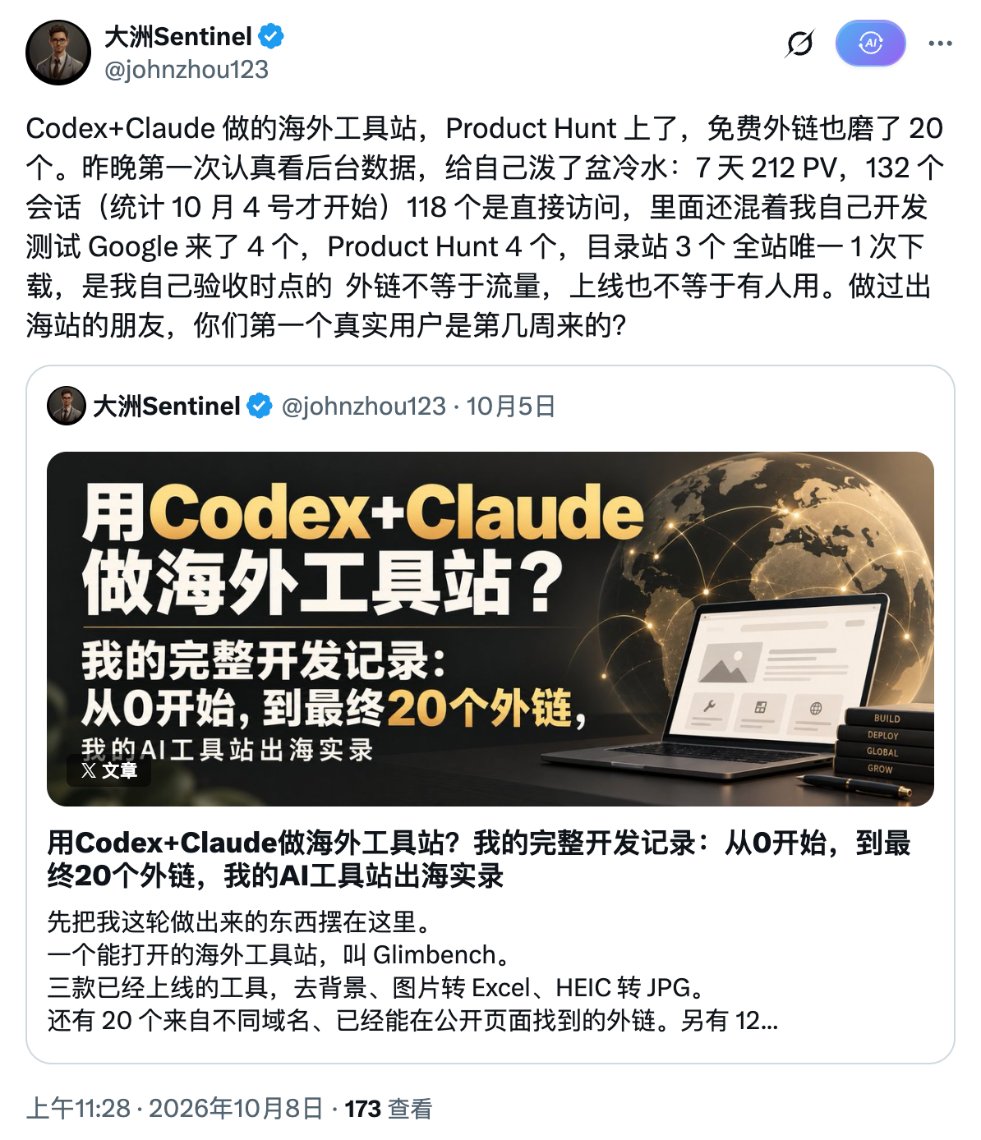
• @johnzhou123:反面冷数据:工具站上了 Product Hunt、磨了 20 个外链,7 天只有 212 PV,全站唯一 1 次下载还是自己验收时点的(据作者说)
这张表我想让你看出两件事。一是 AI 引用带来的转化,普遍比它占的流量比例高得多,Ahrefs 那条 0.5% 流量换 12.1% 注册最典型,因为问 AI “买哪个”的人,本来就是带着钱来的。二是最后那条冷数据,才是大多数人的真实起点。上了 Product Hunt、做了 20 个外链,不等于有人用。别只看那些晒成绩的截图,幸存者偏差害人。
八、几个一定会踩的坑,先给你排了
把前面散落的坑和新的,我统一列一遍,照着避:
迷信 llms.txt 和 schema,这俩前面说透了,基本功可以做,别当救命稻草。
搞混训练爬虫和搜索爬虫,把该放的搜索爬虫给禁了,那是真的一点都别想被引用。
robots.txt 放行了,但 WAF 或者 Cloudflare 在外面那层拦着,等于没放。
重要内容只靠 JS 渲染,爬虫看到的是空壳。
批量造页、买软文去“投毒”。这条我得重点说。新华网记者做过一个实验,虚构了一款根本不存在的水杯,起名叫“泉嘉德”,谐音“全假的”,然后喂给网络,结果几个小时后 AI 就把它当真货推荐出来了(新华网报道)。听着是不是觉得有机可乘?打住。谷歌已经明确把批量造页列为违规,前面 DeepSeek 也说了要过滤 GEO 操纵。这种事短期可能骗到 AI,但平台一收紧,你的站就是第一批被清的,得不偿失。踏踏实实做真内容,才是唯一能长久的路。
看错统计口径,前面 Reddit 那个 46.7% 和 6.6% 的例子就是教训,被人用一个唬人的数字带着跑。
只看单张截图、相信那些承诺“保排名”“保进 AI 推荐”的服务。AI 的回答天天在变,谁敢给你保,谁就是在收智商税。
只在自己站上发内容,不去第三方平台露脸。新站这么做,基本就是自说自话。
国内外一套打法照搬。引擎偏好两套,内容阵地两套,不能混。
最后,别神化 GEO。Diib 的数据显示,目前只有 2.9% 的网站,把 ChatGPT 排进了自己的前五大流量来源(据报道)。它是个正在长大的新机会,值得现在布局,但它还不是你流量的全部。把它当成一个新增的渠道去认真做,心态才稳。
九、一份自查清单,照着打勾
写到这我把整篇的动作压成一张清单,你对着自己的站过一遍,缺哪补哪:
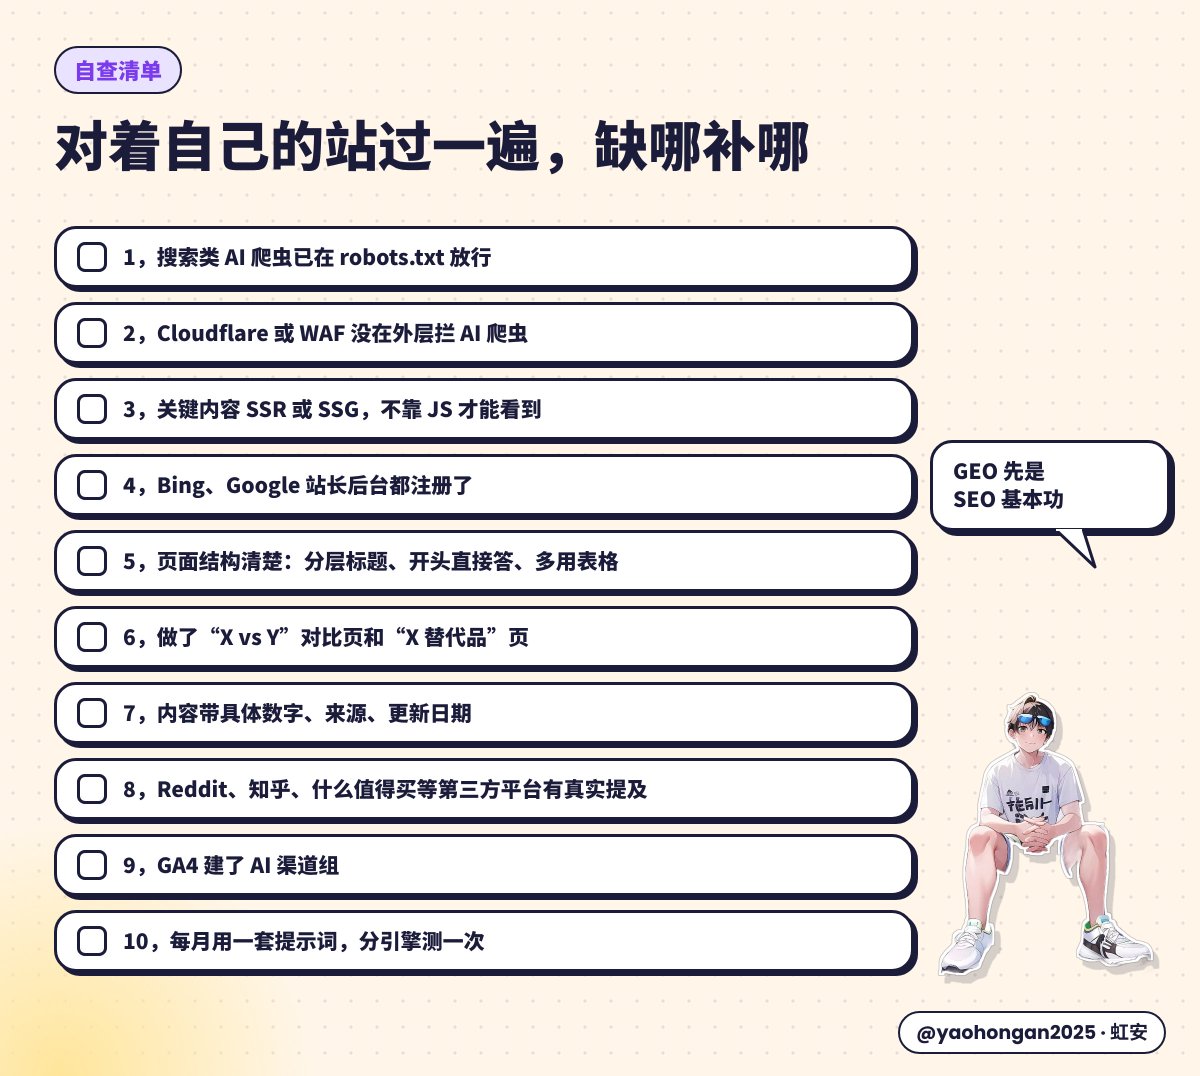
1,搜索类 AI 爬虫是否已在 robots.txt 放行。
2,Cloudflare 或 WAF 是否在外层拦截了 AI 爬虫。
3,关键内容是否 SSR/SSG,不依赖 JS 才能看到。
4,是否注册了 Bing、Google 的站长后台,能看到 AI 相关数据。
5,页面结构是否清晰,标题分层、开头直接答问题、多用表格列表。
6,是否做了“X vs Y”对比页和“X 替代品”页。
7,内容是否带具体数字、来源、更新日期。
8,是否在 Reddit、知乎、什么值得买这类第三方平台有真实提及。
9,GA4 里是否建了 AI 渠道组,能统计到 ChatGPT 来的流量。
10,是否每月用一套提示词,在多个引擎测一次可见度。
最后
写了这么长,其实总结起来就一句话:GEO 首先是把 SEO 的基本功做扎实,再加上让第三方平台真实地提到你,最后加上每个月持续地测、持续地调。没有秘籍,也别信秘籍。
这是保存的副本,原帖可能已修改或删除。