
别再盲目堆 Multi-Agent 了!Google 和 MIT 用 260 组极限对照实验,揭穿了多Agent协作的底层真相。 最近圈子里有个流行风气:只要单个 Agent 搞不定,就无脑上 Mul
原帖发布于
别再盲目堆 Multi-Agent 了!Google 和 MIT 用 260 组极限对照实验,揭穿了多Agent协作的底层真相。
最近圈子里有个流行风气:只要单个 Agent 搞不定,就无脑上 Multi-Agent:拉三五个 Agent 开会、辩论、互相 Review,仿佛 Agent 数量一多,系统就会凭空产生“集体智慧”。
但现实往往是:
Token 烧了 5 倍,延迟拉满,最后出来的结果比单 Agent 还要拉胯。
Google DeepMind、Google Research 联手 MIT 刚发的这篇 44 页重磅论文《Towards a Science of Scaling Agent Systems》,做了一件前人从没做过的事:
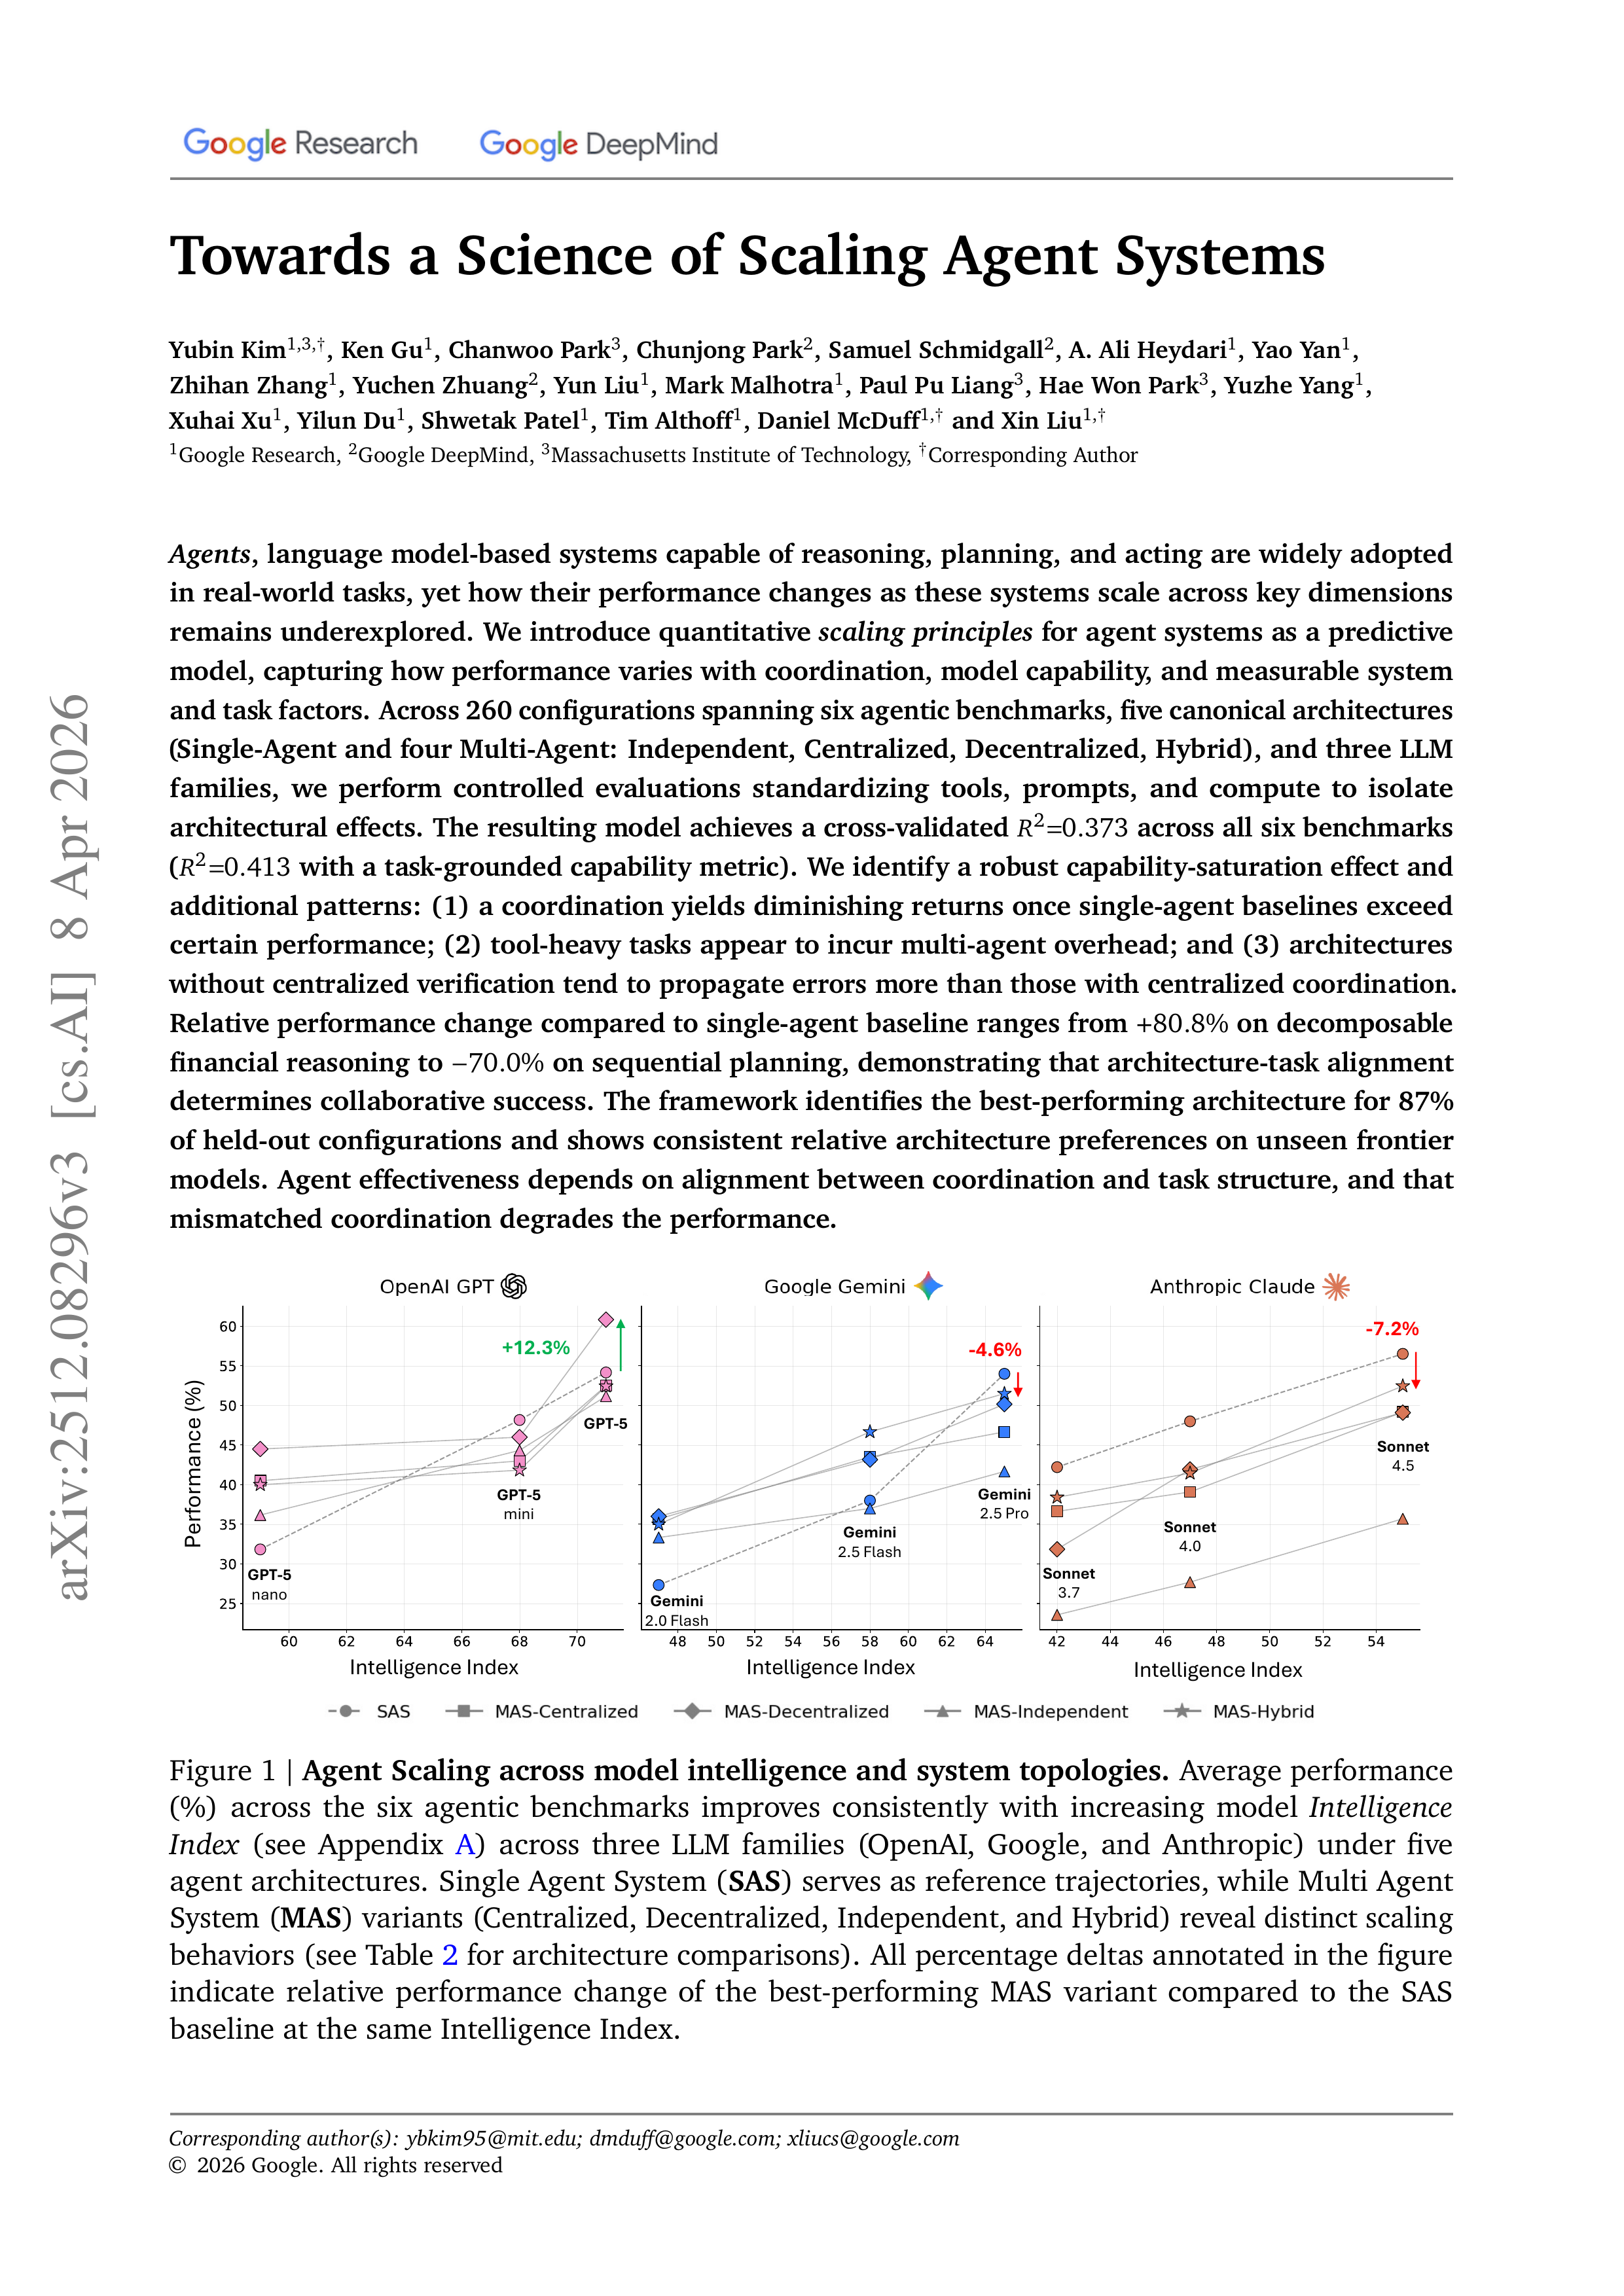
在严格控制算力、Token 总预算和 Prompt 变量的前提下,跨 6 大 Benchmark、5 种主流架构、3 大前沿模型家族(OpenAI / Google / Anthropic),整整跑了 260 组对照实验!
用数学和数据,第一次给 Agent 系统的扩展立下了「科学法则」。
读完整篇论文,信息量大到头皮发麻,这几个反直觉的结论,每一个都在狠抽所谓“最佳实践”的脸:
1. 残酷的平均收益:-0.3%!
大家以为加了 Multi-Agent 就能全方位吊打单 Agent?
实验结果的大盘数据让人大跌眼镜:
跨所有架构和任务,多智能体相比单智能体(SAS)的平均提升竟然是 -0.3%!
而且极化到了恐怖的程度:最高能暴涨 +80.8%,最低能暴跌 -70.0%!
这意味着:
在没搞清楚任务性质之前瞎上多智能体,不仅不是优化,简直是在蓄意破坏。
2. 最扎心的「45% 能力饱和死线」(Baseline Paradox)
这是论文统计学上最硬核的发现(p = 0.004):
临界值就在单 Agent 基线成功率达到 ~45% 的那一刻!
• 当单个 Agent 表现很差(<45%)时,多 Agent 互相补位确实能抢救一下;
• 但一旦单 Agent 自身实力过硬、成功率跨过 45%,Multi-Agent 就会迅速进入收益递减甚至负收益区!
在代码评测 SWE-bench Verified 上,强模型的单 Agent 已经能拿到 45%+,结果上了 MAS 之后全线倒退(下降 2% ~ 15%)。
为什么?因为底座模型越聪明,多智能体之间啰里八嗦的无效沟通、信息压缩损失和协调冲突,就越是纯粹的累赘。
3. “开会甩锅”现场:1 个人 3 步做完的事,3 个人直接干废
论文扒出执行日志(Trace)做机制分析时,极其生动地展现了现场:
• 在强顺序推理任务上(比如 Minecraft 游戏规划 PlanCraft):
单 Agent 路径极简:查配方 -> 拿材料 -> 合成,3 步搞定;
中心化 Multi-Agent 却硬生生把任务拆解成了三个草台班子:Agent 1 负责查配方、Agent 2 负责看背包、Agent 3 负责合成。本来看一眼背包就能完成的事,它们建群发了一堆同步消息,Token 预算在毫无意义的握手和重复汇报中被迅速吃光,性能直接暴跌 70%!
• 但在天然可并行的任务上(比如金融分析 Finance-Agent):
一个人看财报、一个人搜行业监管新闻、一个人算财务指标,再由中控 Orchestrator 汇总。这种自然解耦的任务,Multi-Agent 实现了惊人的 +80.8% 性能爆发!
决定成败的根本不是 Agent 有多能聊,而是你的任务结构到底能不能天然解耦!
4. 沟通开销的超线性爆炸:T = 2.72 × (n + 0.5)^{1.724}论文推导出了 Agent 交互轮数随人数增长的幂律公式。指数高达 1.724,呈现极陡峭的超线性增长!
• 当你堆到 3 个 Agent,去中心化讨论平均要跑 26.1 轮,混合层级架构要跑 44.3 轮,而单 Agent 只要 7.2 轮。
• 看一眼真实生产成本吧:
每 1,000 个 Token 产出的成功次数:
单 Agent 是 67.7;
去中心化掉到 23.9;
混合架构直接腰斩再腰斩,跌到了 13.6(效率缩水整整 5 倍!)。
在现实业务里,你的预算是有限的。Agent 之间疯狂聊天,实质上是在剥夺每个 Agent 独立深度思考的 Token 预算(Token Fragmentation)。
5. 错误放大效应:独立并行的错误会放大 17.2 倍!
没有校验中枢的多智能体,简直是灾难传播机。
论文追踪执行轨迹发现,在完全独立的并行架构中,由于缺乏验证机制,错误放大率(Error Amplification)高达 17.2 倍;
而去中心化多方辩论也有 7.8 倍;
唯一还能看的是中心化 Orchestrator 架构(4.4 倍),中控好歹扮演了“把关人”的角色。
但请注意,它依然比单 Agent(1.0 倍)放大了 4.4 倍的错误。
6. 扎心真相:别指望“大模型当老板,小模型当打工人”
很多团队为了省成本,设想得很美好:用 GPT-5 / Gemini 2.5 Pro / Claude 3.7+ 当 Orchestrator,配几个便宜的小模型(nano/mini/flash)干脏活累活。
论文专门针对 13 种异构(Heterogeneous)配置做了验证,结果无情打脸:
混合团队的表现,比纯大模型团队整整落后了 12.6 个百分点!
小模型产出的幻觉和低质信息,会像污水一样倒灌进大模型的上下文里,最终把整个系统的判断力拉下水。
💡 那么,这篇论文给我们留下了什么工程行动指南?
论文最终给出了一个在测试集上预测准确率达 87% 的量化决策框架。如果你正在架构一个 Agent 系统,请把这张清醒的思维导图焊在脑子里:
论文最终给出了一个在测试集上预测准确率达 87% 的量化决策框架。 如果你正在架构一个 Agent 系统,请把这张清醒的思维导图焊在脑子里:
1. 先做单 Agent 基线(SAS):
如果单 Agent 准确率已经能上 45%,立刻停手!不要加 Multi-Agent,先把精力花在强化单 Agent 的 Tool 质量、Memory 检索和 Prompt 工程上,性价比远高于搭复杂的 Agent 团队。
2. 看任务是“序列约束”还是“平行分支”:
• 强序列依赖(如代码多步 Debug、复杂状态机流转、游戏规划):坚决用单 Agent。强行拆分只会导致灾难性的上下文碎片化。
• 宽广搜索与信息合成(如深度研报调研、多源跨库比对):用 Centralized(中心化中控)架构,让 Worker 并行检索,中控做最终交叉验证。
3. 工具越多的任务,越要谨慎上多 Agent:
工具调用本身就是极高熵的交互,再加上多智能体之间的信息噪音,系统崩溃率会成倍上升。
一句话总结:
“堆 Agent 并不等于堆智慧,很多时候你只是在花 5 倍的预算,让几个大模型在生产环境里合起伙来开虚假周报会。”
停止盲目的多智能体崇拜,让系统回归到任务结构与数学法则上来。
最近圈子里有个流行风气:只要单个 Agent 搞不定,就无脑上 Multi-Agent:拉三五个 Agent 开会、辩论、互相 Review,仿佛 Agent 数量一多,系统就会凭空产生“集体智慧”。
但现实往往是:
Token 烧了 5 倍,延迟拉满,最后出来的结果比单 Agent 还要拉胯。
Google DeepMind、Google Research 联手 MIT 刚发的这篇 44 页重磅论文《Towards a Science of Scaling Agent Systems》,做了一件前人从没做过的事:
在严格控制算力、Token 总预算和 Prompt 变量的前提下,跨 6 大 Benchmark、5 种主流架构、3 大前沿模型家族(OpenAI / Google / Anthropic),整整跑了 260 组对照实验!
用数学和数据,第一次给 Agent 系统的扩展立下了「科学法则」。
读完整篇论文,信息量大到头皮发麻,这几个反直觉的结论,每一个都在狠抽所谓“最佳实践”的脸:
1. 残酷的平均收益:-0.3%!
大家以为加了 Multi-Agent 就能全方位吊打单 Agent?
实验结果的大盘数据让人大跌眼镜:
跨所有架构和任务,多智能体相比单智能体(SAS)的平均提升竟然是 -0.3%!
而且极化到了恐怖的程度:最高能暴涨 +80.8%,最低能暴跌 -70.0%!
这意味着:
在没搞清楚任务性质之前瞎上多智能体,不仅不是优化,简直是在蓄意破坏。
2. 最扎心的「45% 能力饱和死线」(Baseline Paradox)
这是论文统计学上最硬核的发现(p = 0.004):
临界值就在单 Agent 基线成功率达到 ~45% 的那一刻!
• 当单个 Agent 表现很差(<45%)时,多 Agent 互相补位确实能抢救一下;
• 但一旦单 Agent 自身实力过硬、成功率跨过 45%,Multi-Agent 就会迅速进入收益递减甚至负收益区!
在代码评测 SWE-bench Verified 上,强模型的单 Agent 已经能拿到 45%+,结果上了 MAS 之后全线倒退(下降 2% ~ 15%)。
为什么?因为底座模型越聪明,多智能体之间啰里八嗦的无效沟通、信息压缩损失和协调冲突,就越是纯粹的累赘。
3. “开会甩锅”现场:1 个人 3 步做完的事,3 个人直接干废
论文扒出执行日志(Trace)做机制分析时,极其生动地展现了现场:
• 在强顺序推理任务上(比如 Minecraft 游戏规划 PlanCraft):
单 Agent 路径极简:查配方 -> 拿材料 -> 合成,3 步搞定;
中心化 Multi-Agent 却硬生生把任务拆解成了三个草台班子:Agent 1 负责查配方、Agent 2 负责看背包、Agent 3 负责合成。本来看一眼背包就能完成的事,它们建群发了一堆同步消息,Token 预算在毫无意义的握手和重复汇报中被迅速吃光,性能直接暴跌 70%!
• 但在天然可并行的任务上(比如金融分析 Finance-Agent):
一个人看财报、一个人搜行业监管新闻、一个人算财务指标,再由中控 Orchestrator 汇总。这种自然解耦的任务,Multi-Agent 实现了惊人的 +80.8% 性能爆发!
决定成败的根本不是 Agent 有多能聊,而是你的任务结构到底能不能天然解耦!
4. 沟通开销的超线性爆炸:T = 2.72 × (n + 0.5)^{1.724}论文推导出了 Agent 交互轮数随人数增长的幂律公式。指数高达 1.724,呈现极陡峭的超线性增长!
• 当你堆到 3 个 Agent,去中心化讨论平均要跑 26.1 轮,混合层级架构要跑 44.3 轮,而单 Agent 只要 7.2 轮。
• 看一眼真实生产成本吧:
每 1,000 个 Token 产出的成功次数:
单 Agent 是 67.7;
去中心化掉到 23.9;
混合架构直接腰斩再腰斩,跌到了 13.6(效率缩水整整 5 倍!)。
在现实业务里,你的预算是有限的。Agent 之间疯狂聊天,实质上是在剥夺每个 Agent 独立深度思考的 Token 预算(Token Fragmentation)。
5. 错误放大效应:独立并行的错误会放大 17.2 倍!
没有校验中枢的多智能体,简直是灾难传播机。
论文追踪执行轨迹发现,在完全独立的并行架构中,由于缺乏验证机制,错误放大率(Error Amplification)高达 17.2 倍;
而去中心化多方辩论也有 7.8 倍;
唯一还能看的是中心化 Orchestrator 架构(4.4 倍),中控好歹扮演了“把关人”的角色。
但请注意,它依然比单 Agent(1.0 倍)放大了 4.4 倍的错误。
6. 扎心真相:别指望“大模型当老板,小模型当打工人”
很多团队为了省成本,设想得很美好:用 GPT-5 / Gemini 2.5 Pro / Claude 3.7+ 当 Orchestrator,配几个便宜的小模型(nano/mini/flash)干脏活累活。
论文专门针对 13 种异构(Heterogeneous)配置做了验证,结果无情打脸:
混合团队的表现,比纯大模型团队整整落后了 12.6 个百分点!
小模型产出的幻觉和低质信息,会像污水一样倒灌进大模型的上下文里,最终把整个系统的判断力拉下水。
💡 那么,这篇论文给我们留下了什么工程行动指南?
论文最终给出了一个在测试集上预测准确率达 87% 的量化决策框架。如果你正在架构一个 Agent 系统,请把这张清醒的思维导图焊在脑子里:
论文最终给出了一个在测试集上预测准确率达 87% 的量化决策框架。 如果你正在架构一个 Agent 系统,请把这张清醒的思维导图焊在脑子里:
1. 先做单 Agent 基线(SAS):
如果单 Agent 准确率已经能上 45%,立刻停手!不要加 Multi-Agent,先把精力花在强化单 Agent 的 Tool 质量、Memory 检索和 Prompt 工程上,性价比远高于搭复杂的 Agent 团队。
2. 看任务是“序列约束”还是“平行分支”:
• 强序列依赖(如代码多步 Debug、复杂状态机流转、游戏规划):坚决用单 Agent。强行拆分只会导致灾难性的上下文碎片化。
• 宽广搜索与信息合成(如深度研报调研、多源跨库比对):用 Centralized(中心化中控)架构,让 Worker 并行检索,中控做最终交叉验证。
3. 工具越多的任务,越要谨慎上多 Agent:
工具调用本身就是极高熵的交互,再加上多智能体之间的信息噪音,系统崩溃率会成倍上升。
一句话总结:
“堆 Agent 并不等于堆智慧,很多时候你只是在花 5 倍的预算,让几个大模型在生产环境里合起伙来开虚假周报会。”
停止盲目的多智能体崇拜,让系统回归到任务结构与数学法则上来。