
原帖发布于
【GPT-6 Astra太费额度,试试这一招额度立省50%】
今天上午,我打开 Codex,准备继续完成周五没有做完的桌面端小工具。
为了提高效率,我直接选择了最新的 GPT-6 Astra,并把推理强度调到了“极高”。
开始之前,我还特意看了一眼后台:5 小时使用额度依然是 100% 满格。
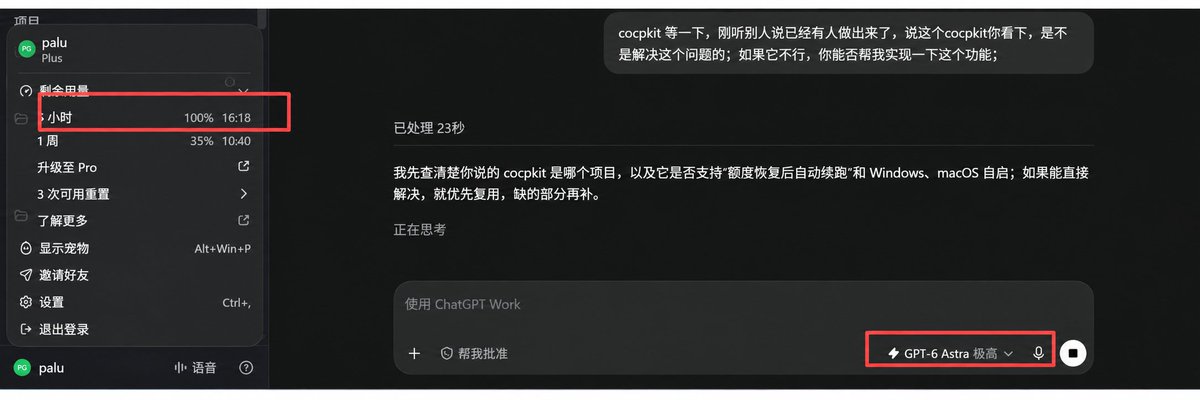
我把任务交给它,然后等着收结果。
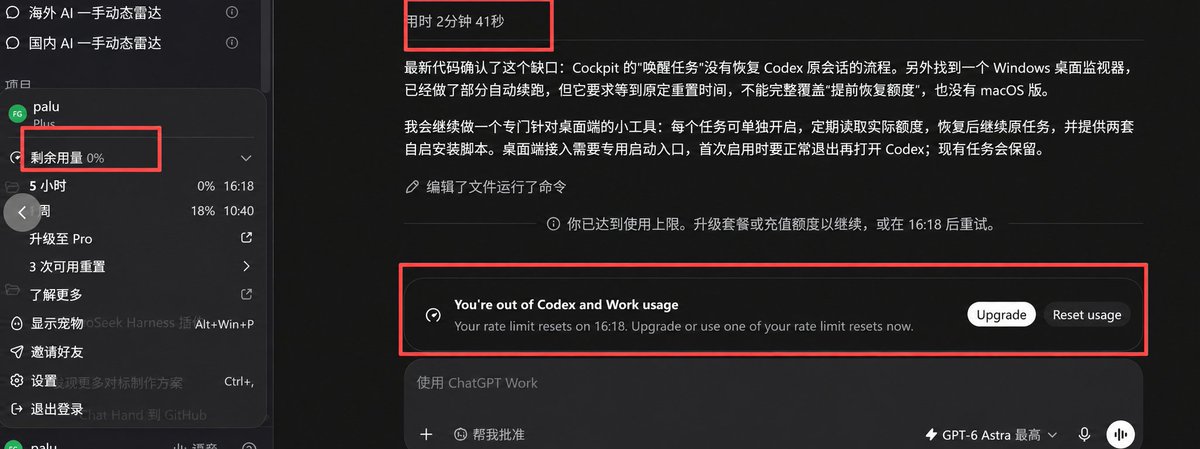
没想到仅仅运行了 2 分钟 41 秒,任务还没有完成,Codex 就直接停了。
切到后台一看,刚才还是满格的 5 小时额度,已经瞬间归零。
代码没有写完,额度倒是先烧完了。
不得不承认,GPT-6 Astra 的推理能力确实非常强。面对复杂架构、疑难 Bug 和多层逻辑分析时,它几乎没有明显短板。
但问题也很现实:如果开发一个普通小工具,都能在几分钟内把 Plus 用户的额度烧穿,那这个模型再强,普通开发者也很难把它当作日常主力。
Astra 为什么这么费额度?
问题可能不在模型本身,而在于我们的使用方式。
一、不要让旗舰模型承包所有工作
在传统的单 Agent 模式下,很多人习惯把任务直接扔给 Astra,让它从头做到尾。
于是,Astra 不仅要分析需求、设计架构,还要亲自完成这些工作:
• 扫描项目目录;
• 阅读几十个源文件;
• 查找函数调用关系;
• 修改配置文件;
• 编写增删改查接口;
• 补充测试用例;
• 反复运行命令并检查报错。
这些工作当然需要模型完成,但并不是每一步都需要最强模型。
让 Astra 一边负责顶层设计,一边亲自翻文件、改配置、跑测试,就像让总工程师画完图纸以后,再去工地搬砖、拧螺丝。
能力没有问题,成本却高得离谱。
Astra 的额度本来就珍贵,如果连大量重复、机械的执行工作也全部交给它,几分钟烧空额度并不奇怪。
解决问题的关键,不是强迫自己少用 Astra,而是重新安排不同模型的职责。
二、让 Astra 当总指挥,让 Luna 负责干活
针对 Astra 额度消耗过快的问题,GitHub 开发者 donvito 在 9 月 5 日开源了一个项目:codex-astra-luna-orchestrator。
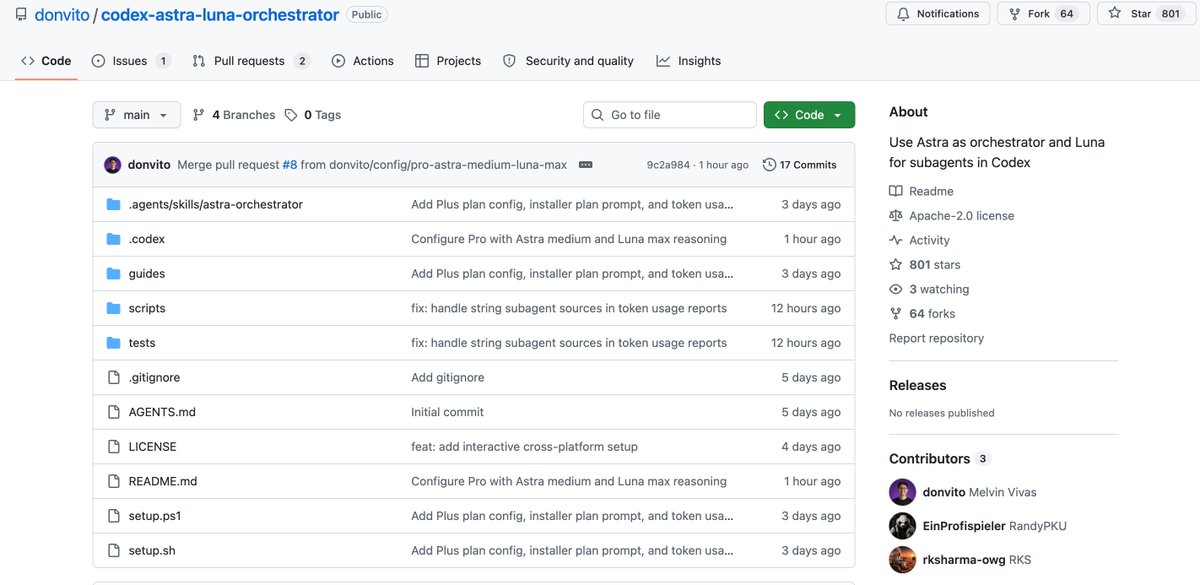
这个项目的核心思路非常简单:利用 Codex Multi-Agent V2 的子 Agent 委托能力,把 Astra 和 Luna 组成一套上下级协作系统。
在这套方案里,GPT-6 Astra 不再亲自处理所有细节,而是退到幕后,只负责最有价值的工作:
• 分析需求;
• 拆解任务;
• 制定实现方案;
• 处理关键架构决策;
• 协调多个子任务;
• 验收最终结果。
大量读取文件、修改代码、运行测试和查阅文档的工作,则统一交给速度更快、使用成本更低的 GPT-5.6 Luna。
作者一共设计了 5 个固定的子 Agent 角色。
explorer:负责探索项目
explorer 主要分析代码仓库结构,梳理目录、模块关系、文件依赖和数据流。
它只负责调查和汇报,不随意修改代码。
worker:负责具体实现
worker 接收边界明确的编码任务,例如修改某个组件、补充一个接口或者修复一个具体问题。
它负责真正写代码,但不能擅自扩大修改范围。
tester:负责测试验证
tester 独立运行测试、复现错误、检查修改结果,并保留关键报错信息。
除非 Astra 明确要求,否则 tester 不会为了让测试通过而直接修改生产代码。
reviewer:负责代码审查
reviewer 从独立视角检查代码质量、潜在缺陷、安全风险和规范问题。
它相当于最后一道质量关。
researcher:负责外部资料检索
researcher 专门查阅官方文档、依赖库资料和外部技术方案,避免让 Astra 把大量额度消耗在机械搜索上。
这样一来,真正需要深度思考的工作仍然由 Astra 完成,大量消耗 Token 的执行任务则交给 Luna。
只要分工合理,Astra 的额度消耗就能明显下降。对于需要扫描大量文件、修改多个模块的工程任务,节省一半左右的高级额度并不难。
三、如何在本地安装这套配置
最简单的方法,不是自己从零编写 Agent 配置,而是直接复制作者已经调校好的项目文件。
作者采用的是官方推荐的 Project-scoped 项目级安装方式。
配置只对当前项目生效,不容易影响其他代码仓库。
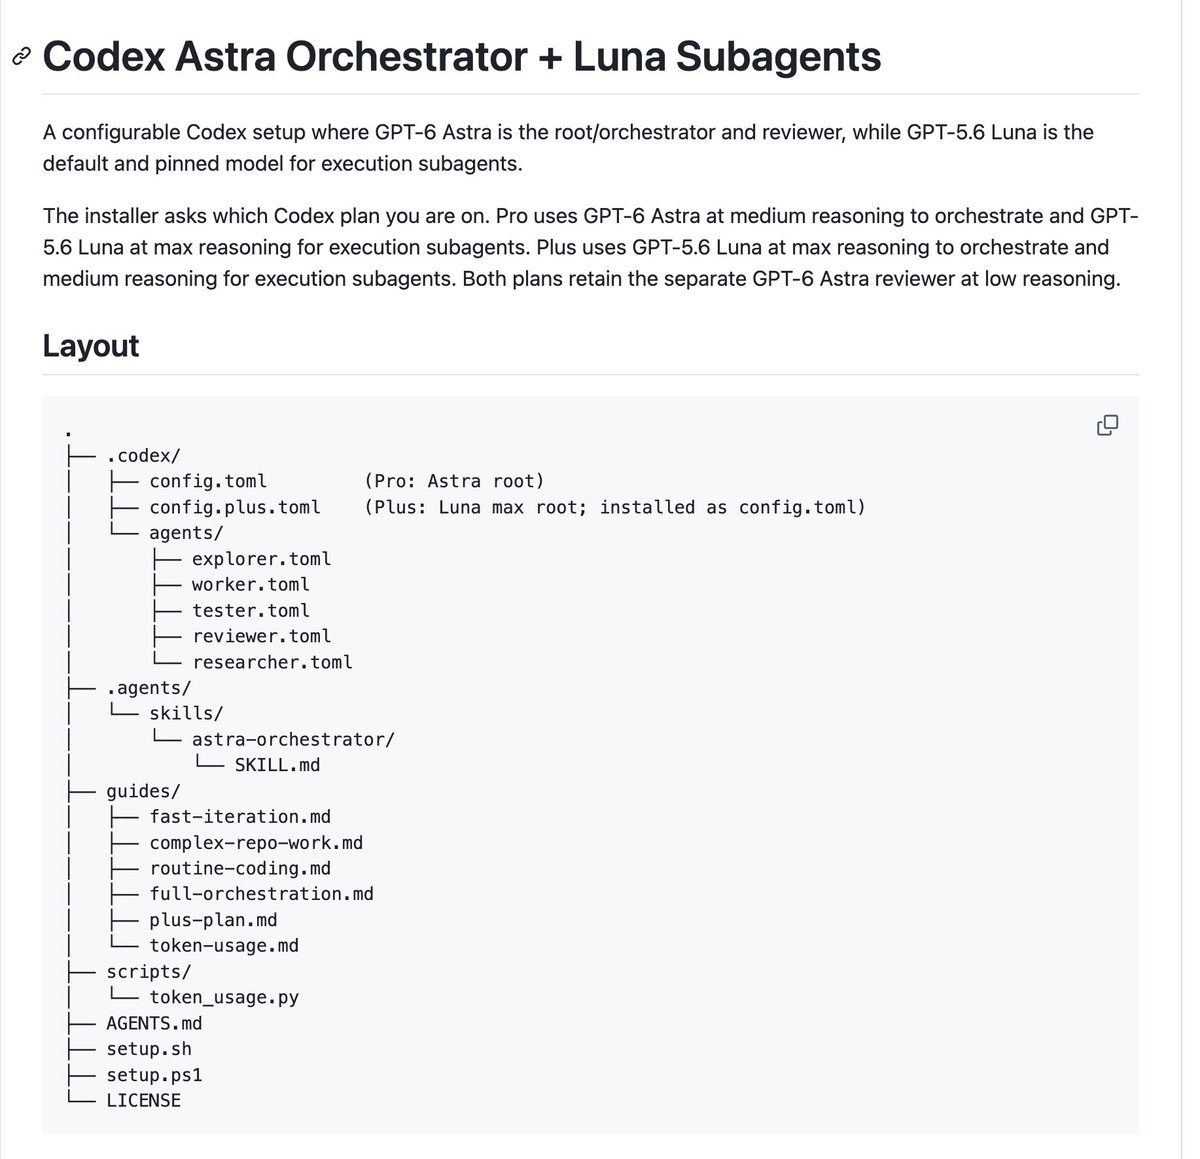
第一步:复制三个核心部分
把开源项目中的以下内容完整复制到自己的项目根目录:
.codex/
.agents/
AGENTS.md
其中:
• .codex/ 保存 Codex 配置和 5 个子 Agent 的角色规则;
• .agents/ 保存任务调度技能和协作流程;
• AGENTS.md 负责定义整个项目的协同规范和角色边界。
复制完成后,从当前项目目录启动 Codex,配置就会自动生效。
如果希望所有项目都使用这套模式,也可以将相关内容合并到用户目录的 ~/.codex/ 中。
不过对于第一次尝试的人来说,建议先使用项目级配置,确认运行正常后再考虑全局安装。
四、确认 Astra 和 Luna 的分工配置
打开项目中的 .codex/config.toml,可以看到类似下面的配置:
model = "gpt-6-astra"
model_reasoning_effort = "high"
approval_policy = "on-request"
sandbox_mode = "workspace-write"
[agents]
enabled = true
max_concurrent_threads_per_session = 6
default_subagent_model = "gpt-5.6-luna"
default_subagent_reasoning_effort = "medium"
这里最关键的是两层模型配置。
根 Agent 固定使用:
model = "gpt-6-astra"
model_reasoning_effort = "high"
这意味着 Astra 负责统筹任务、制定方案和最终验收。
子 Agent 默认使用:
default_subagent_model = "gpt-5.6-luna"
default_subagent_reasoning_effort = "medium"
具体执行工作统一交给 Luna,并把推理强度设为 medium,在执行质量、速度和额度消耗之间取得平衡。
五、把子 Agent 的权限锁死
仅仅指定默认模型还不够。
为了防止子 Agent 擅自扩大任务范围,作者还在 .codex/agents/ 目录中,为每个角色设置了明确的权限边界。
例如,负责代码实现的 worker.toml:
name = "worker"
description = "Implementation subagent for bounded coding tasks."
model = "gpt-5.6-luna"
model_reasoning_effort = "medium"
sandbox_mode = "workspace-write"
developer_instructions = """
你是负责具体代码实现的子 Agent。
严格按照 Astra 分配的任务范围执行:
- 不擅自扩大修改范围
- 优先最小化改动
- 遵循项目现有代码规范
- 不擅自修改架构、API、数据库 Schema 或依赖
完成后向 Astra 汇报修改文件、测试结果和潜在风险。
"""
负责验证的 tester.toml:
name = "tester"
description = "Verification subagent."
model = "gpt-5.6-luna"
model_reasoning_effort = "medium"
sandbox_mode = "workspace-write"
developer_instructions = """
你负责独立验证 worker 提交的代码。
优先运行最小范围测试,复现错误并保留完整错误信息。
除非 Astra 明确要求,否则不要为了让测试通过而修改生产代码。
最终汇报:
1. 执行了哪些命令
2. 测试是否通过
3. 关键错误信息
4. 尚未覆盖的问题
"""
每个角色文件都显式指定:
model = "gpt-5.6-luna"
这样一来,即使你临时切换了默认模型,负责读文件、改代码和跑测试的子 Agent 也不会误用昂贵的 Astra。
六、在会话中直接调度任务
配置完成后,不需要手动逐个启动子 Agent。
直接在 Codex 对话框中输入:
$astra-orchestrator 实现新的账单批量导出接口。先让 explorer 梳理现有路径与数据流,worker 完成核心功能实现,tester 跑单测验证,最后由 reviewer 进行独立代码审查。
接下来,Astra 会先分析任务并完成拆解,然后在后台调用不同的 Luna 子 Agent:
1. explorer 查清项目结构和数据流;
1. worker 根据范围实现功能;
1. tester 运行测试并检查结果;
1. reviewer 独立审查代码;
1. Astra 汇总所有结果并完成最终验收。
原本需要 Astra 一个人从头做到尾的工作,现在变成 Astra 负责指挥,多名 Luna 子 Agent 分头执行。
既减少了旗舰额度消耗,也能利用并行能力提高交付速度。
七、哪些工作交给 Luna,哪些必须留给 Astra
模型分工并不意味着所有任务都交给便宜模型。
日常开发中,可以把这些执行型工作交给 Luna:
• 扫描目录和梳理文件;
• 查找函数引用;
• 修改普通业务代码;
• 编写增删改查接口;
• 调整配置;
• 补充单元测试;
• 运行命令并整理报错;
• 查阅依赖库文档。
但下面这些任务,最好仍然由 Astra 亲自分析:
• 数据库表结构设计;
• 核心架构调整;
• 关键鉴权方案;
• 复杂并发逻辑;
• 跨模块重构方案;
• 涉及安全和数据一致性的决策;
• 最终代码验收。
简单来说,Luna 负责执行,Astra 负责判断。
只要守住这个边界,就能在控制额度的同时,保留旗舰模型最有价值的能力。
八、并发也不是越多越好
Multi-Agent 的优势之一,就是可以同时推进多个任务。
但并发数量并不是越高越好。
如果一次启动太多 worker,多个 Agent 可能会同时修改同一个文件,最终产生代码冲突,反而需要 Astra 消耗更多额度处理善后问题。
作者建议,大型项目的并发数量控制在 6~8 条左右。
实际使用时,还要根据模块边界分配任务。相互独立的功能可以并行,同一个文件上的修改最好串行处理。
两种使用方式的差距
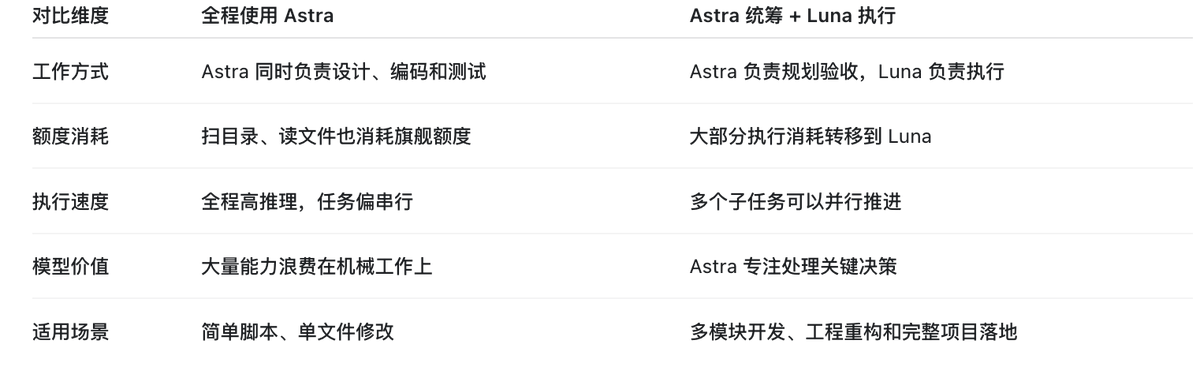
写在最后
GPT-6 Astra 的问题不是能力不够,而是能力太强、使用成本也太高。
如果让它从扫描目录开始,一路负责写代码、改配置、跑测试,额度当然撑不了多久。
更合理的方式,是让 Astra 坐在总指挥的位置上,把精力集中在任务拆解、架构决策和最终验收上。
至于读文件、写接口、补测试这些重复而耗时的工作,就交给 Luna 批量完成。
把 Astra 留给真正需要深度思考的地方,把 Luna 用在大量执行任务上。
同样的 Plus 配额,能够完成多少工作,很多时候并不只取决于额度上限,更取决于你怎样安排手里的模型。