
原帖发布于
【OpenClaw 账单爆炸?九大维度实操砍掉60–90% Token(亲测后台降70%+) 】
今天分享下社区里大家常见的省 Token 办法,加上我自己整理配置、跑了好几个代理实际测出来的经验。
OpenClaw 的 Token 消耗其实挺好懂的。你真正问的问题和 AI 回的话只占 5–20%。剩下 80–95% 基本都在交隐形开销。比如配置文件每次都全量注入,历史对话越聊越长,后台心跳和 Cron 老是拖着大上下文,工具输出还永久留在历史里。
通过针对性优化,这些隐形开销可以砍掉大半。下面从杠杆最高到进阶的技巧,分享九大维度,基本覆盖了大多数玩家的使用场景。建议先跑几条命令看看自己现在的情况:
• /status:当前会话大概烧了多少
• /usage full:每次回复后的详细 breakdown
• /context detail:看看哪些文件/历史在吃大头
• du -h ~/.openclaw/agents/*/sessions/*.jsonl | sort -h:会话文件超 500KB 就该警惕了
一个小亲测案例:我之前有个监控代理(sysmon)一直用 Sonnet 做心跳检查,每天几十次调用,后台部分消耗占了整体账单的快40%。后来按维度一和五改成DeepSeek-V3 + 隔离Cron + 豆包1.5后,这个代理的月消耗直接降了70%以上。现在后台任务基本不心疼了,整体用着更敢放开了。
维度一:模型分层使用
模型选错是最容易烧钱的地方。别让旗舰模型干杂活。
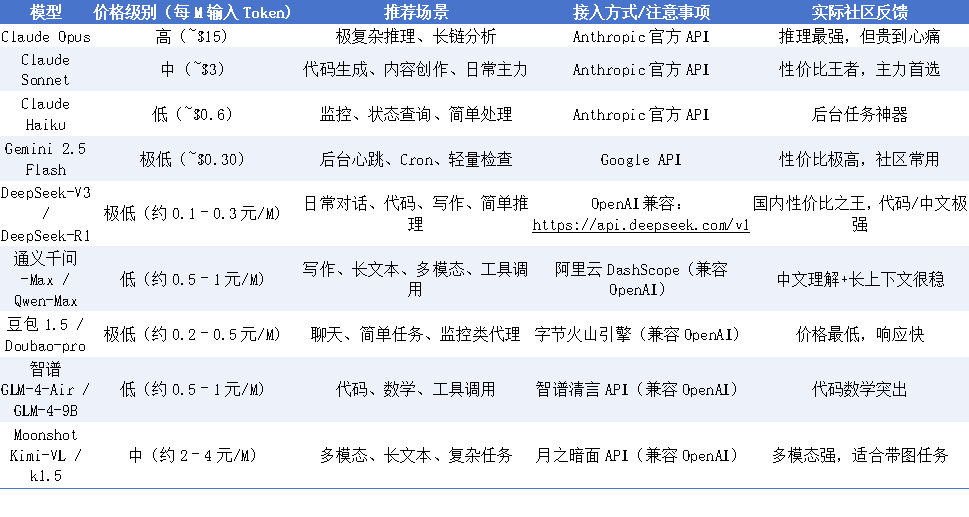
配置示例(以DeepSeek为例):
国内用户推荐分层组合:
• 日常主力/代码/写作:DeepSeek-V3 或 通义千问-Max(性价比爆表,中文能力吊打大部分海外模型)
• 监控/心跳/Cron:豆包1.5 或 Gemini 2.5 Flash(最省钱,基本白嫖级别)
• 复杂推理/长上下文:智谱 GLM-4-Air 或 通义千问-Max(推理链强,接近Sonnet)
• 多模态/带图任务:Moonshot Kimi-VL 或 Qwen-VL-Max(国内多模态天花板)
会话里随时切模型:/model openai/deepseek-chat(或直接写模型名)。
记得关闭不必要的thinking/reasoning 模式("thinking": {"type": "disabled"}),,避免无谓消耗放大。
维度二:配置文件精简
核心配置文件(SOUL.md、AGENTS.md、USER.md、TOOLS.md)在每次 API 调用时都会完整注入,构成固定开销。
精简目标:
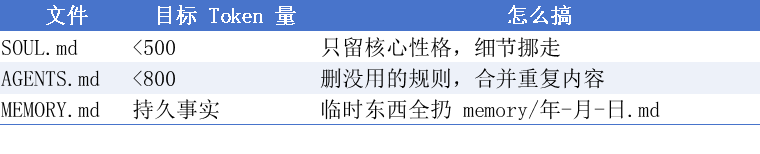
推荐使用 $include 语法共享公共规则,减少文件碎片。核心文件改动频率应尽量降低,以维持提示缓存有效性。
维度三:技能模块优化
技能描述部分每次都会注入系统提示,即使未被调用也产生固定成本(单个技能约 50–100 Token)。
优化方法:
1. 只保留真正高频使用的技能,其余改为手动调用
1. 低频技能添加 disable-model-invocation: true,彻底阻止自动注入
1. 描述字段保持极简(仅写触发条件),详细逻辑放入技能正文(按需加载)
示例:
维度四:会话历史管理
历史对话随轮次指数增长,常占上下文窗口 40–60%,成为长期消耗主力。
核心策略:
• 压缩时先切换低成本模型:/model haiku → /compact → 恢复主力模型
• 设置软阈值 + 定时重置:
• 大型输出任务隔离到子代理:/subagents spawn main "任务描述",仅返回最终结论
• 定期检查并清理过大 session 文件
维度五:心跳与定时任务(附 Bug 注意事项)
原生 Heartbeat 存在模型覆盖不生效的常见问题,实际运行时往往使用默认(较贵)模型,且触发频率有时异常频繁(比如设30分钟但实际10–20秒一次,消耗指数级增长)。
推荐方案:关闭原生心跳("heartbeat": {"every": "0m"}),全部迁移到隔离会话的 Cron 任务,使用低成本模型如 Gemini 2.5 Flash 或国内豆包1.5:
配置自动清理:"cron": {"sessionRetention": "24h"},并限制日志大小 "runLog": { "maxBytes": "2mb", "keepLines": 2000 }。多任务尽量合并为单次调用,节省75%上下文注入成本。实际测试后,后台消耗可降50–80%。
维度六:多代理体系的差异化配置
全局统一配置容易造成资源错配。应根据代理职责分别设置模型、上下文窗口、压缩策略,避免监控类代理用大窗口浪费、开发类代理上下文不够用的问题。
推荐分层:
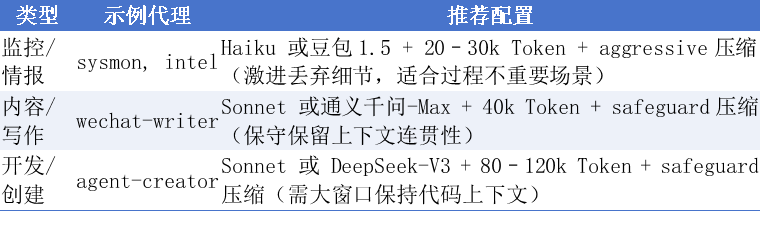
在 agents.list 中逐个 override,例如:
实际调整后,能消除全局一刀切的浪费,整体消耗精准控制降20–40%。
维度七:提示缓存利用最大化
启用并维持提示缓存可将固定内容读取费用降至约 10%。
关键配置:
保持配置文件前缀稳定,定时任务间隔略小于 TTL 以维持缓存热度。
维度八:工具调用与并发优化
工具调用产生的输出若长期留在历史,会持续放大后续每次调用的上下文负担。
优化规则(建议写入 AGENTS.md):
• 优先使用精确检索工具,避免读取完整文件
• 多个独立查询合并为一次批量调用
• 大规模输出任务隔离到子代理
• 设置 maxConcurrent: 1,图像处理降采样 imageMaxDimensionPx: 800
维度九:本地模型与路由尝试(进阶)
2026 年本地大模型性能已相当成熟,可将部分低复杂度任务完全转移到本地运行,几乎实现 0 API 成本。
常见实践:
• 使用 Llama 3.1 / Qwen2.5 等量化模型处理监控、状态检查、简单格式化任务
• 部署轻量路由层(如社区的 ClawRouter 或自定义脚本),根据任务复杂度动态分发:
~ 极简单 → 本地模型
~ 中等 → Gemini Flash / DeepSeek
~ 高复杂 → Claude Sonnet
此维度适合有较好硬件(显卡 ≥ 24GB VRAM)的用户,初期可从小范围 Cron 任务开始迁移。
额外:成本监控与安全防护
• 在 Anthropic / 其他提供商控制台设置每日消费上限
• 子代理并发限制:"subagents": {"maxConcurrent": 3}
• 在 TOOLS.md 中加入预算监控逻辑,接近阈值(例如 75%)时主动提醒
优先级实施清单
以上九大维度,是基于社区反馈和自身实践反复验证后提炼出的最实用路径。
P0(最高优先,先执行):
1. 关闭原生心跳 → 迁移到隔离 Cron + 廉价模型
1. 实施模型分层(主力 Sonnet,后台/子代理 Haiku/Flash)
1. 添加每日历史自动重置 + softThresholdTokens
P1(强烈推荐):
配置文件与技能精简、多代理差异化配置、提示缓存开启
P2(进阶优化):
工具调用规范、本地模型路由尝试
完成以上步骤后,Token 消耗通常可降低 60–90%,具体效果视使用场景而定。
建议边实施边通过 /usage full 观察变化,逐步迭代。欢迎在评论区分享你的配置或遇到的问题,一起完善这份指南。
祝你在 OpenClaw 的使用中既高效又省钱!🦞
⚠️风险提示与注意事项
- 以上优化基于社区常见实践和个人测试,实际效果因代理数量、任务复杂度、模型版本、API 提供商等因素而异。请小范围测试后逐步全量应用。
- 更换模型、Cron 迁移、压缩策略等操作可能导致短期功能异常或输出质量波动,建议先备份配置文件和 session 文件。
- API 费用仍受官方定价波动影响,建议定期查看账单并设置消费上限,避免意外超支。
- 本文不构成任何投资或技术建议,仅供参考,操作风险自负。
往期 OpenClaw 相关文章(欢迎关注我获取更多更新)
- [OpenClaw 云端 0 成本部署全流程拆解](https://x.com/Jason23818126/status/2026523498336891050)
- [玩转 OpenClaw :新手必装的 16 个 Skills 配置指南](https://x.com/Jason23818126/status/2028752103628320930)
- [手把手教你部署 OpenClaw + Qveris,零成本实现 24 小时美港 A 股分析](https://x.com/Jason23818126/status/2029387010344141260)
- [OpenClaw 硬核教程:带你 0 代码部署 1 个 6 人机构级投研团队(Multi-Agent 系列)](https://x.com/Jason23818126/status/2030104582131798415)
更多 OpenClaw 省钱/进阶玩法持续更新中,欢迎关注我 @Jason23818126 ,一起玩转AI 代理!🦞
有问题随时评论或私信~